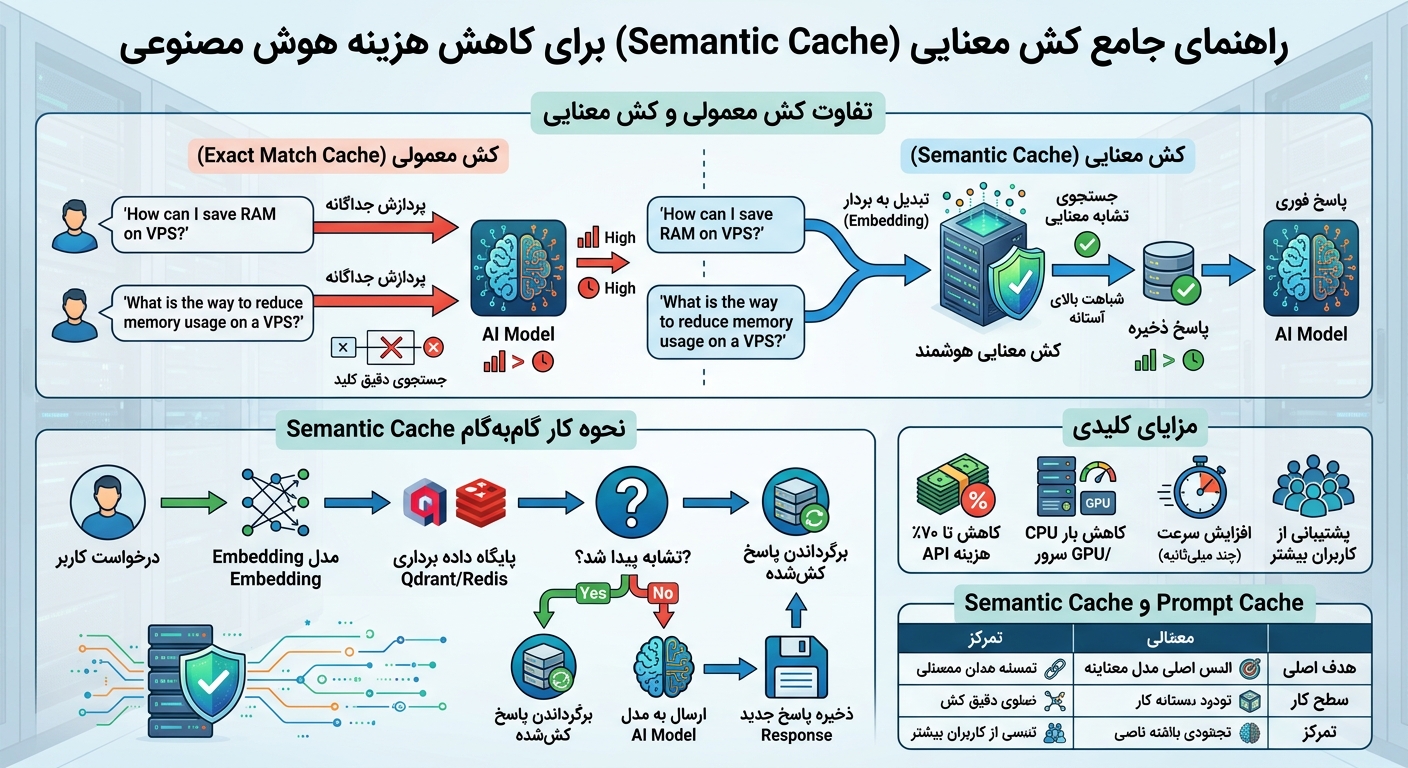
آموزشی 📅 8 مهر 1405 Semantic Cache چیست؟ راهنمای کامل ساخت کش معنایی برای API هوش مصنوعی و کاهش هزینه و زمان پاسخ اگر یک چتبات، AI Agent، سیستم RAG یا API هوش مصنوعی دارید، احتمالاً بخشی از درخواستهای کاربران از نظر معنا...
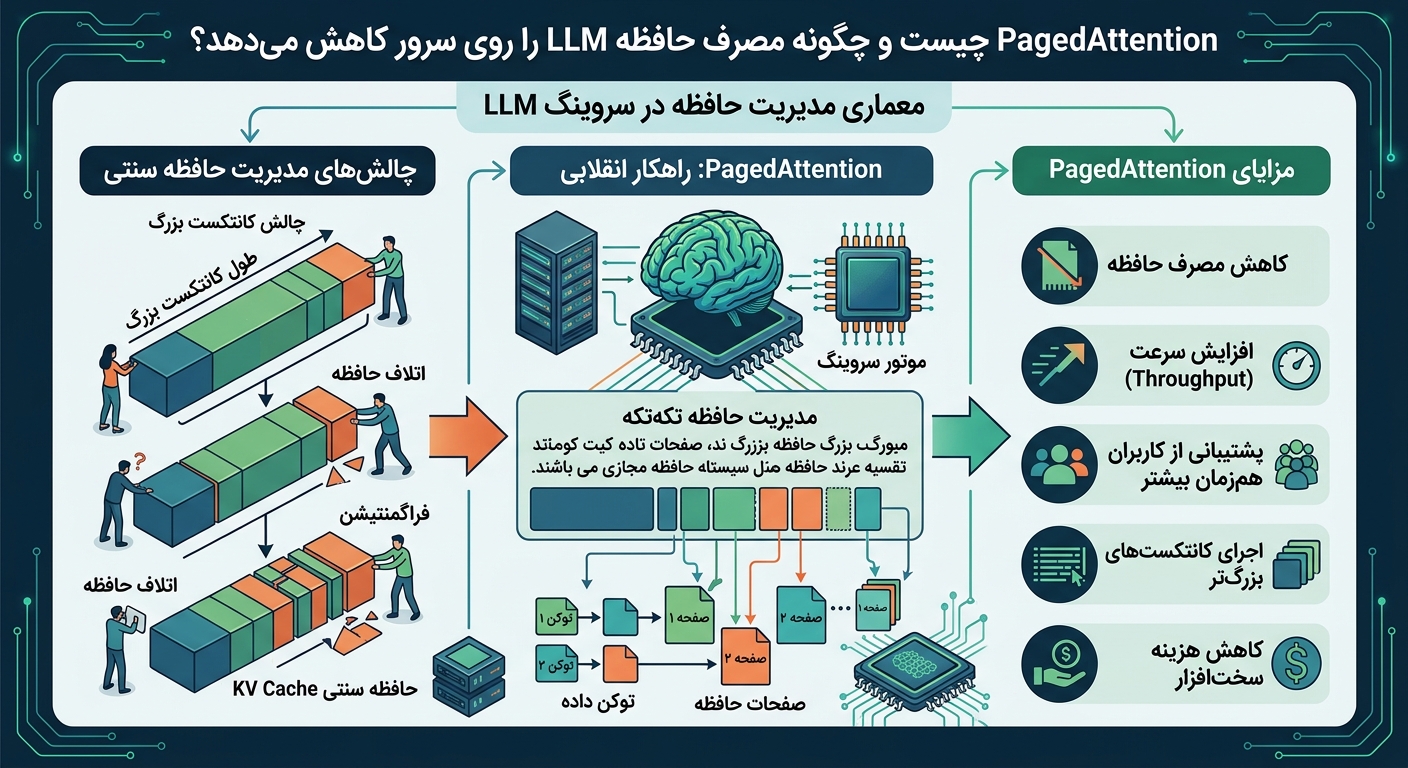
آموزشی 📅 8 مهر 1405 PagedAttention چیست؟ راهنمای کامل کاهش مصرف حافظه LLM روی سرور GPU اگر روی یک سرور GPU مدل زبانی بزرگ سرو میکنید، احتمالاً با این واقعیت روبهرو شدهاید که با وجود VRAM...
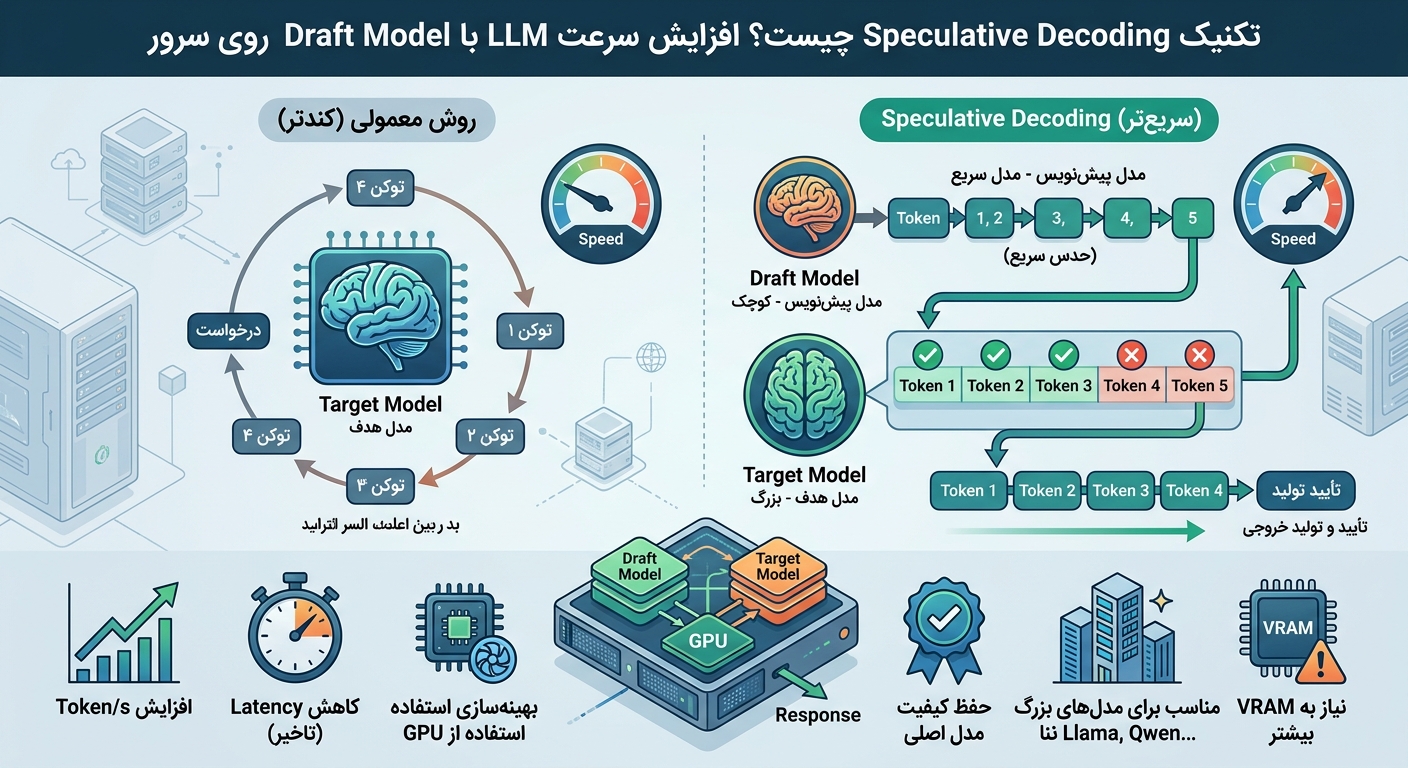
آموزشی 📅 8 مهر 1405 Speculative Decoding چیست؟ راهنمای عملی افزایش سرعت LLM روی سرور GPU اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل...
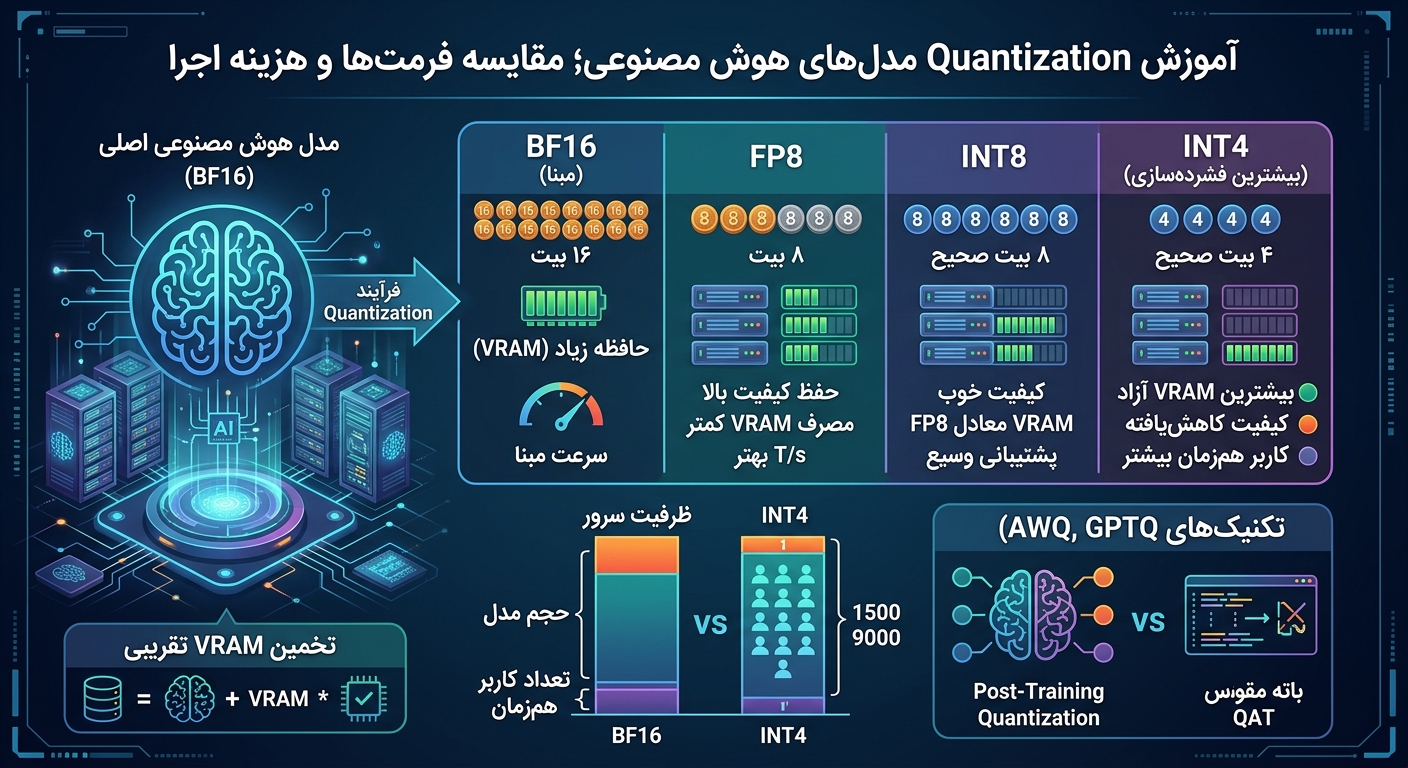
آموزشی 📅 8 مهر 1405 Quantization مدلهای هوش مصنوعی: تفاوت INT4، INT8، FP8 و BF16 در مصرف منابع سرور اجرای مدلهای زبانی بزرگ روی سرور شخصی، یکی از جذابترین روشها برای ساخت سرویسهای AI خصوصی، چتبات، RAG و API...
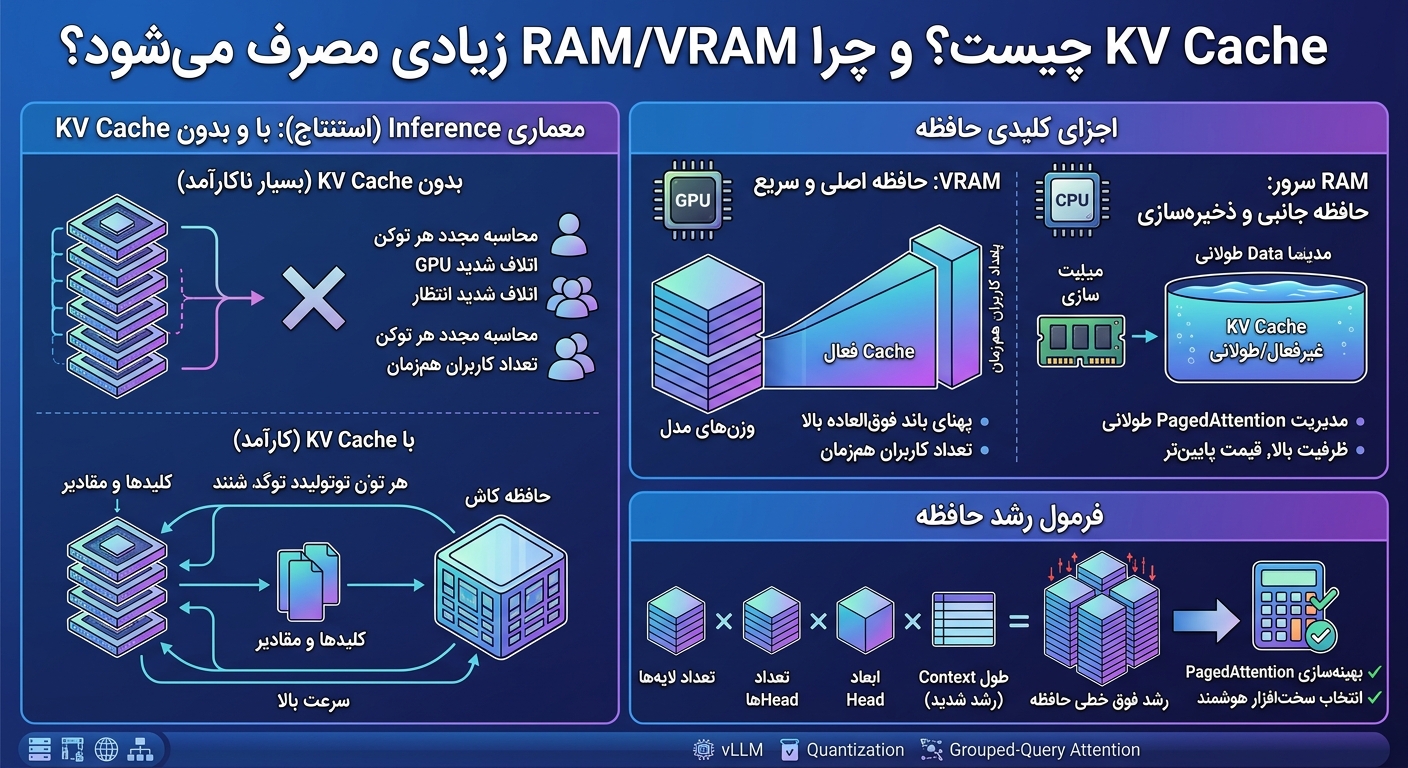
آموزشی 📅 8 مهر 1405 KV Cache و بحران حافظه در سرورهای هوش مصنوعی: چرا VRAM شما کافی نیست؟ تصور کنید یک سرور مجازی قدرتمند با یک کارت گرافیک حرفهای اجاره کردهاید. همهچیز طبق محاسبات شما پیش میرود: حجم...
آموزشی 📅 6 مهر 1405 آموزش نصب Mem0 روی سرور؛ اضافه کردن حافظه دائمی به AI Agent و ساخت هوش مصنوعی با حافظه شخصی یکی از بزرگترین محدودیتهای مدلهای هوش مصنوعی مانند ChatGPT، Claude یا مدلهای متنباز این است که بعد از پایان هر...
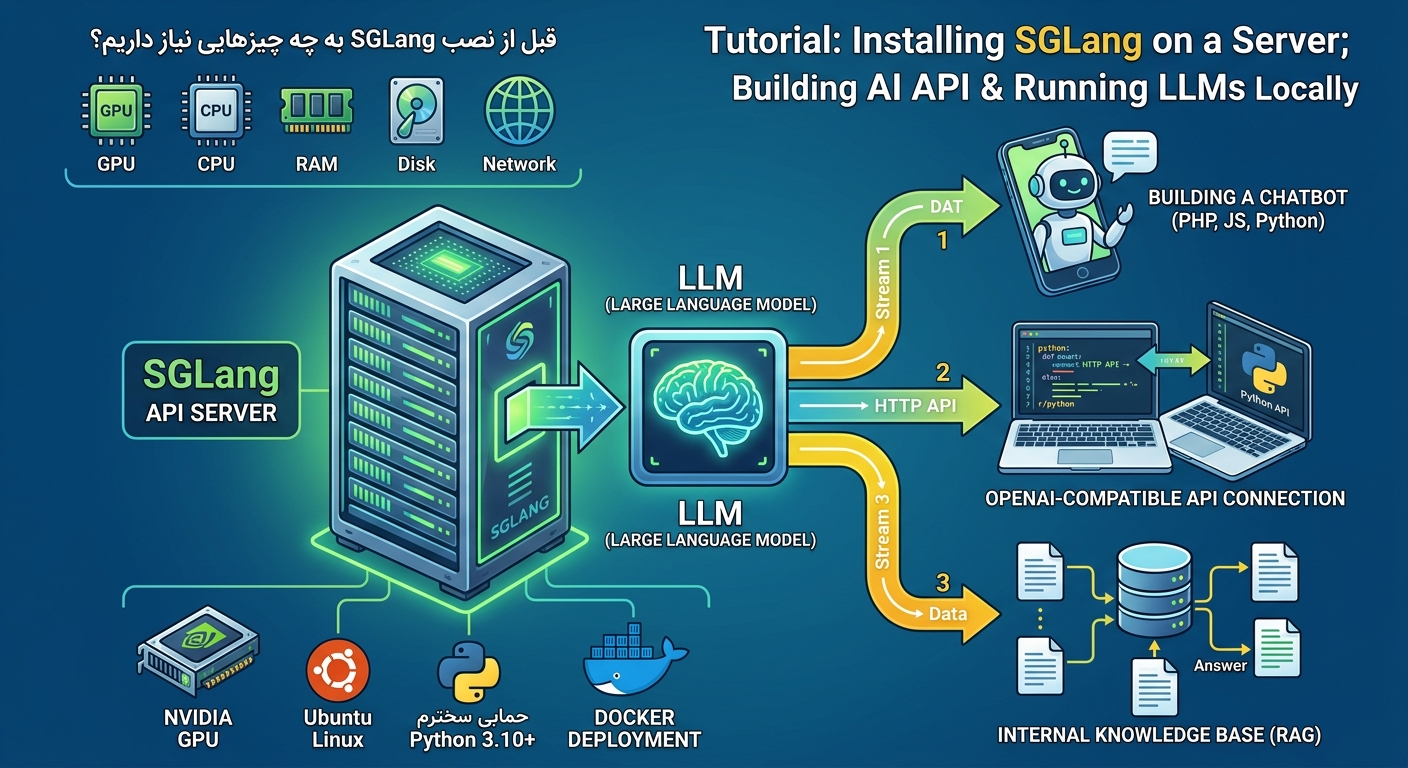
آموزشی 📅 6 مهر 1405 آموزش راهاندازی و اجرای SGLang روی سرور مجازی؛ ساخت API هوش مصنوعی اختصاصی اگر بهدنبال راهی برای اجرای مدلهای زبانی بزرگ (LLM) روی زیرساخت شخصی خودتان هستید و میخواهید یک API مشابه سرویسهای...
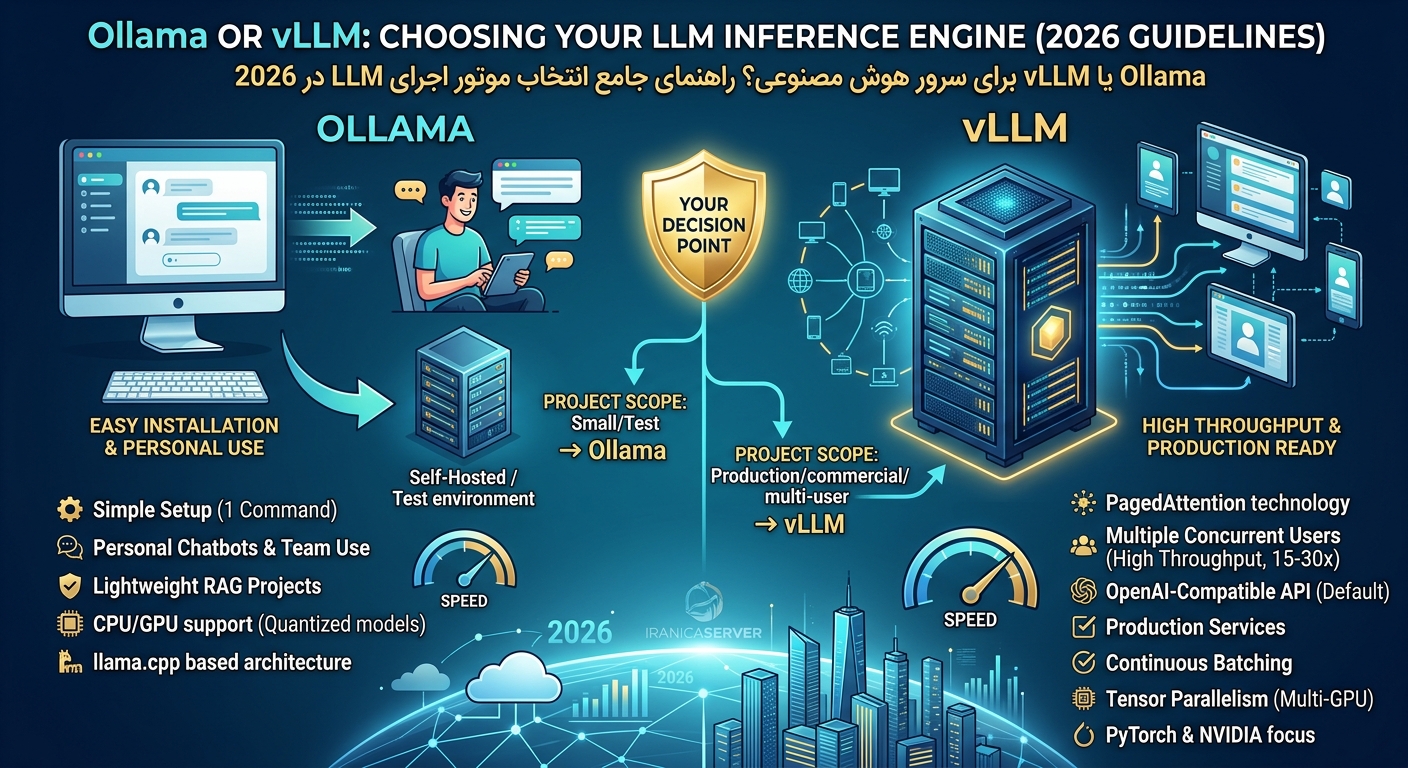
آموزشی 📅 5 مهر 1405 Ollama یا vLLM برای سرور هوش مصنوعی؟ راهنمای جامع انتخاب موتور اجرای LLM در 2026 اگر قصد راهاندازی سرور هوش مصنوعی شخصی یا سرویس API مبتنی بر LLM دارید، احتمالاً با دو نام آشنا روبرو...
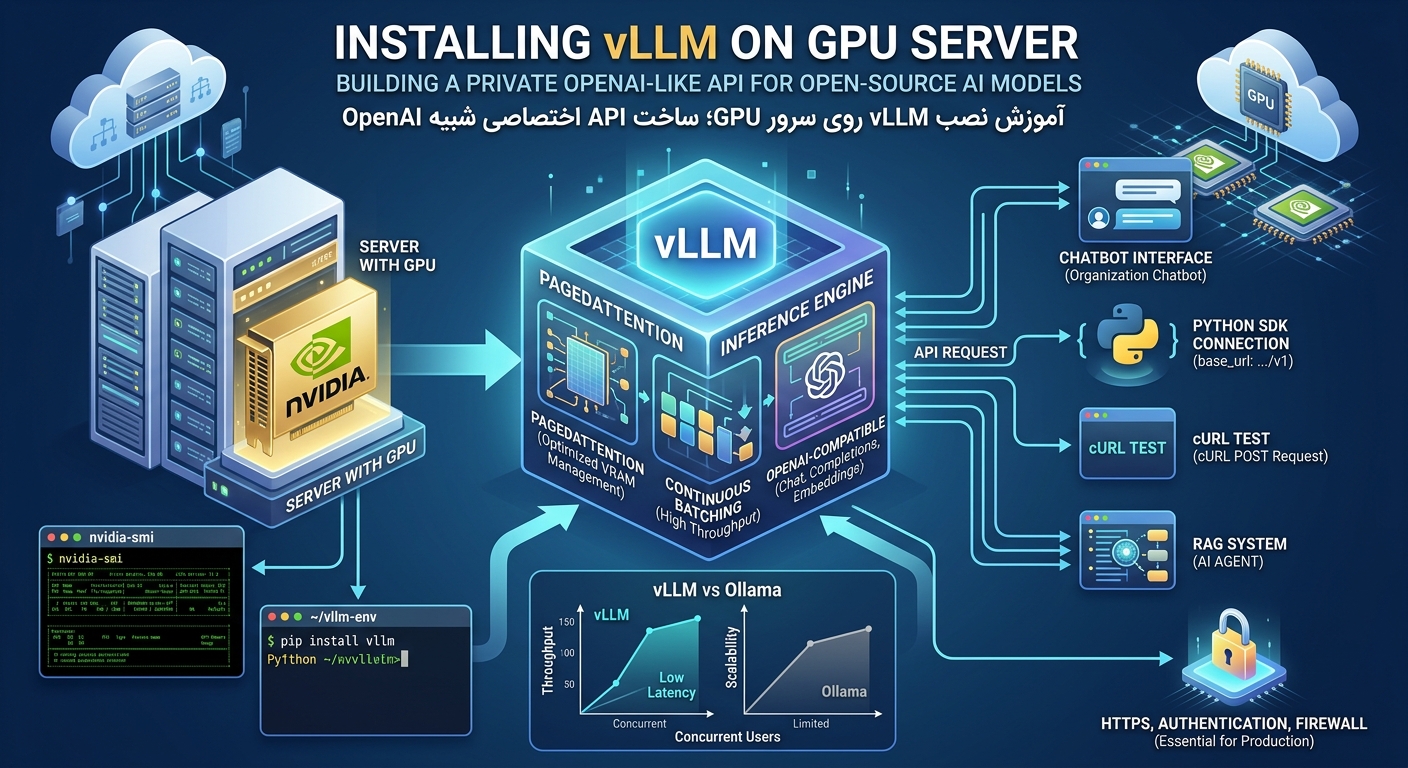
آموزشی 📅 5 مهر 1405 آموزش نصب vLLM روی سرور GPU؛ ساخت API اختصاصی شبیه OpenAI برای مدلهای هوش مصنوعی متنباز اگر قصد دارید یک مدل زبانی بزرگ متنباز را روی سرور خودتان اجرا کنید و بهجای وابستگی به APIهای خارجی،...