
 Amir Jabbari
حالا تصور کنید Agent در گفتگوهای قبلی وضعیت یک سرور را «آنلاین» گزارش کرده است. آیا باید هفته بعد نیز بدون بررسی دوباره، همان وضعیت را معتبر بداند؟ قطعاً خیر؛ زیرا وضعیت سرورها، سفارشها، موجودیها و بسیاری از اطلاعات عملیاتی دائماً تغییر میکنند.
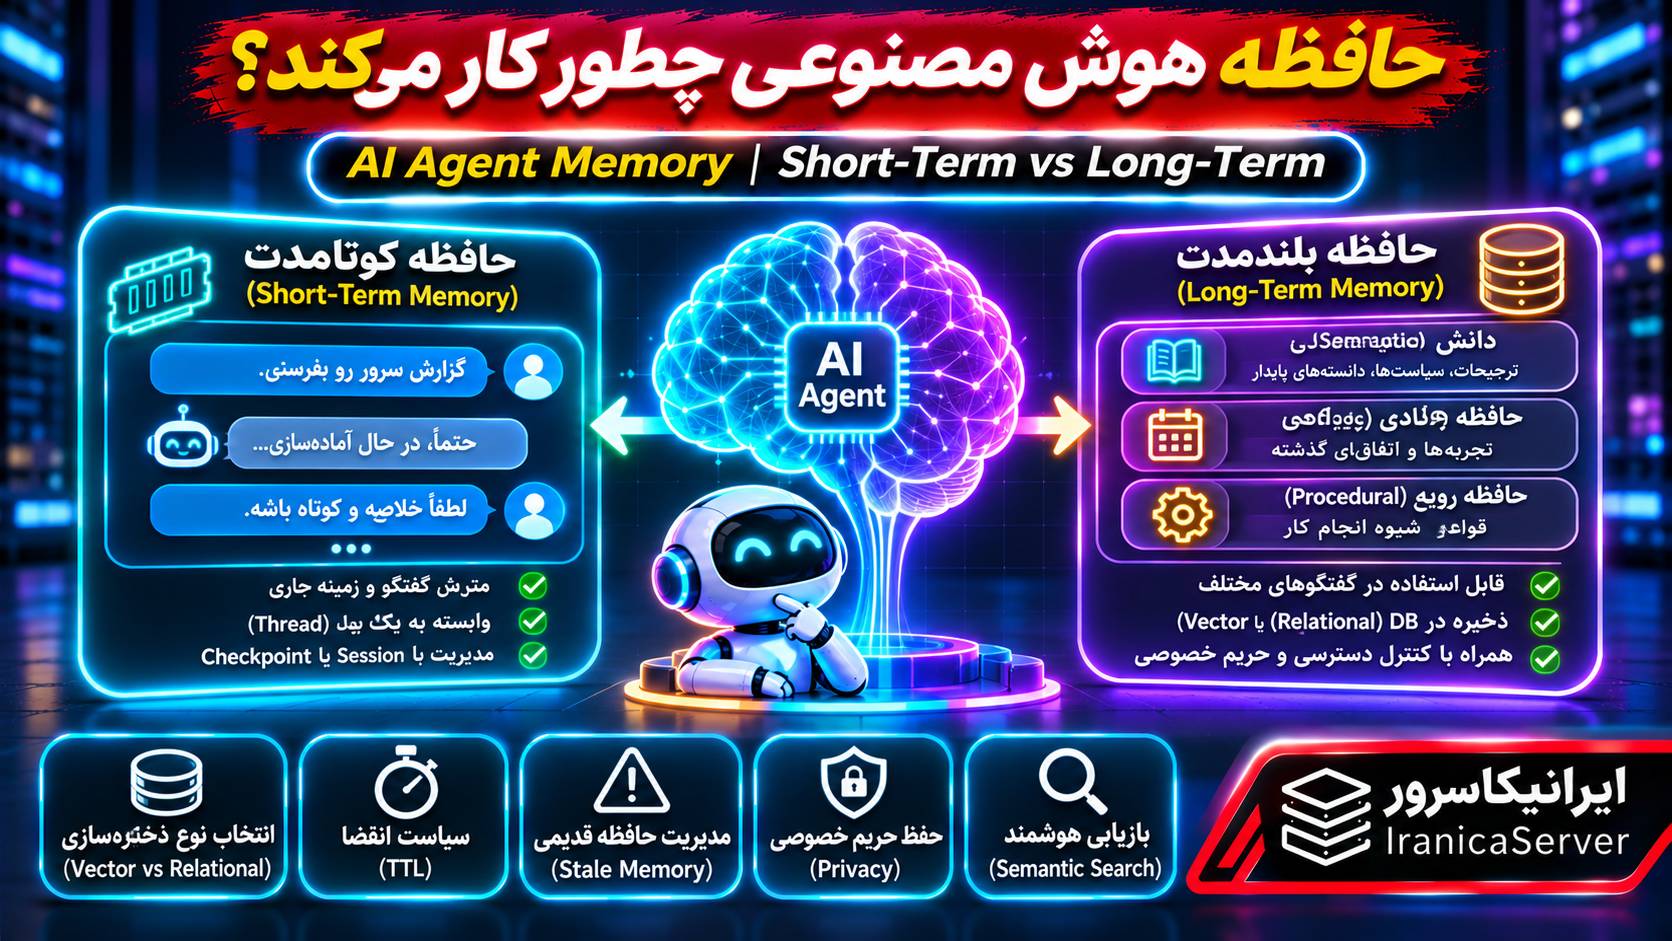
اینجاست که مفهوم AI Agent Memory اهمیت پیدا میکند. حافظه Agent فقط ذخیره پیامهای قبلی نیست؛ بلکه سیستمی برای تشخیص اطلاعات ارزشمند، نگهداری آنها در محدوده مناسب، بازیابی هنگام نیاز، اصلاح دانستههای قدیمی و جلوگیری از افشای اطلاعات خصوصی است.
برای طراحی درست این سیستم باید میان Short-Term Memory یا حافظه کوتاهمدت و Long-Term Memory یا حافظه بلندمدت تفاوت قائل شویم. حافظه کوتاهمدت معمولاً وضعیت گفتگوی جاری را حفظ میکند؛ اما حافظه بلندمدت میتواند اطلاعاتی مانند ترجیحات کاربر، تجربههای گذشته Agent یا دانش ماندگار برنامه را میان چند گفتگو به اشتراک بگذارد.
در این مقاله، معماری حافظه Agent را بهصورت عملی آموزش میدهیم. ابتدا انواع Semantic، Episodic و Procedural Memory را بررسی میکنیم؛ سپس با Python و SQLite یک سیستم حافظه روی VPS میسازیم که برای اطلاعات مختلف TTL، منبع، زمان اعتبار و قابلیت اصلاح یا حذف داشته باشد.
در ادامه نیز مقایسه دیتابیس رابطهای و برداری، استفاده از PostgreSQL و pgvector، بازیابی ترکیبی، محافظت از حریم خصوصی، مدیریت Stale Memory و روش ارزیابی کیفیت حافظه را بررسی خواهیم کرد.
AI Agent Memory چیست و چرا Agent به حافظه نیاز دارد؟
حافظه Agent مجموعهای از سازوکارهای ذخیره و بازیابی اطلاعات است که به یک سیستم هوش مصنوعی کمک میکند در تعاملهای مختلف، از زمینه گفتگو و اطلاعات معتبر قبلی استفاده کند.
یک مدل زبانی ممکن است بتواند اطلاعات موجود در Context فعلی را پردازش کند، اما این موضوع به معنی داشتن حافظه پایدار مستقل از برنامه نیست.
اگر برنامه شما پیامهای قبلی را ذخیره نکند یا اطلاعات لازم را در درخواست بعدی در اختیار مدل قرار ندهد، Agent ممکن است نتواند به زمینه قبلی مراجعه کند.
حافظه چه مشکلی را حل میکند؟
فرض کنید کاربر چند بار با Agent پشتیبانی گفتگو میکند. اگر هیچ حافظهای وجود نداشته باشد، ممکن است در هر مراجعه مجبور شود اطلاعات مشابهی را دوباره توضیح دهد.
با طراحی حافظه میتوان بعضی اطلاعات مفید را نگهداری کرد؛ برای مثال، زبان ترجیحی پاسخ، قالب گزارش یا نتیجه یک عملیات آزمایشی.
اما اگر سیستم تمام اطلاعات را بدون بررسی ذخیره کند، ممکن است حافظه به منبع اطلاعات نادرست، تکراری و خصوصی تبدیل شود.
آیا حافظه بیشتر همیشه بهتر است؟
خیر. افزایش حجم حافظه میتواند باعث بازیابی اطلاعات نامرتبط، افزایش هزینه Token، تأخیر بیشتر و حتی کاهش دقت پاسخ شود.
هدف طراحی Memory این نیست که Agent همه چیز را برای همیشه به خاطر بسپارد؛ هدف این است که اطلاعات مناسب، برای مدت مناسب، با مجوز مناسب و در زمان مناسب بازیابی شوند.
تفاوت Short-Term Memory و Long-Term Memory در Agent چیست؟
یکی از اصلیترین تصمیمهای معماری، تعیین محدوده هر نوع حافظه است.
Short-Term Memory؛ حافظه گفتگوی جاری
حافظه کوتاهمدت اطلاعات موردنیاز یک گفتگو یا گردش کار مشخص را نگهداری میکند.
برای مثال:
- پیامهای اخیر کاربر و Agent.
- موضوع فعلی گفتگو.
- نتایج موقت Toolها.
- اطلاعات لازم برای پاسخ بعدی.
- وضعیت مرحله جاری یک Workflow.
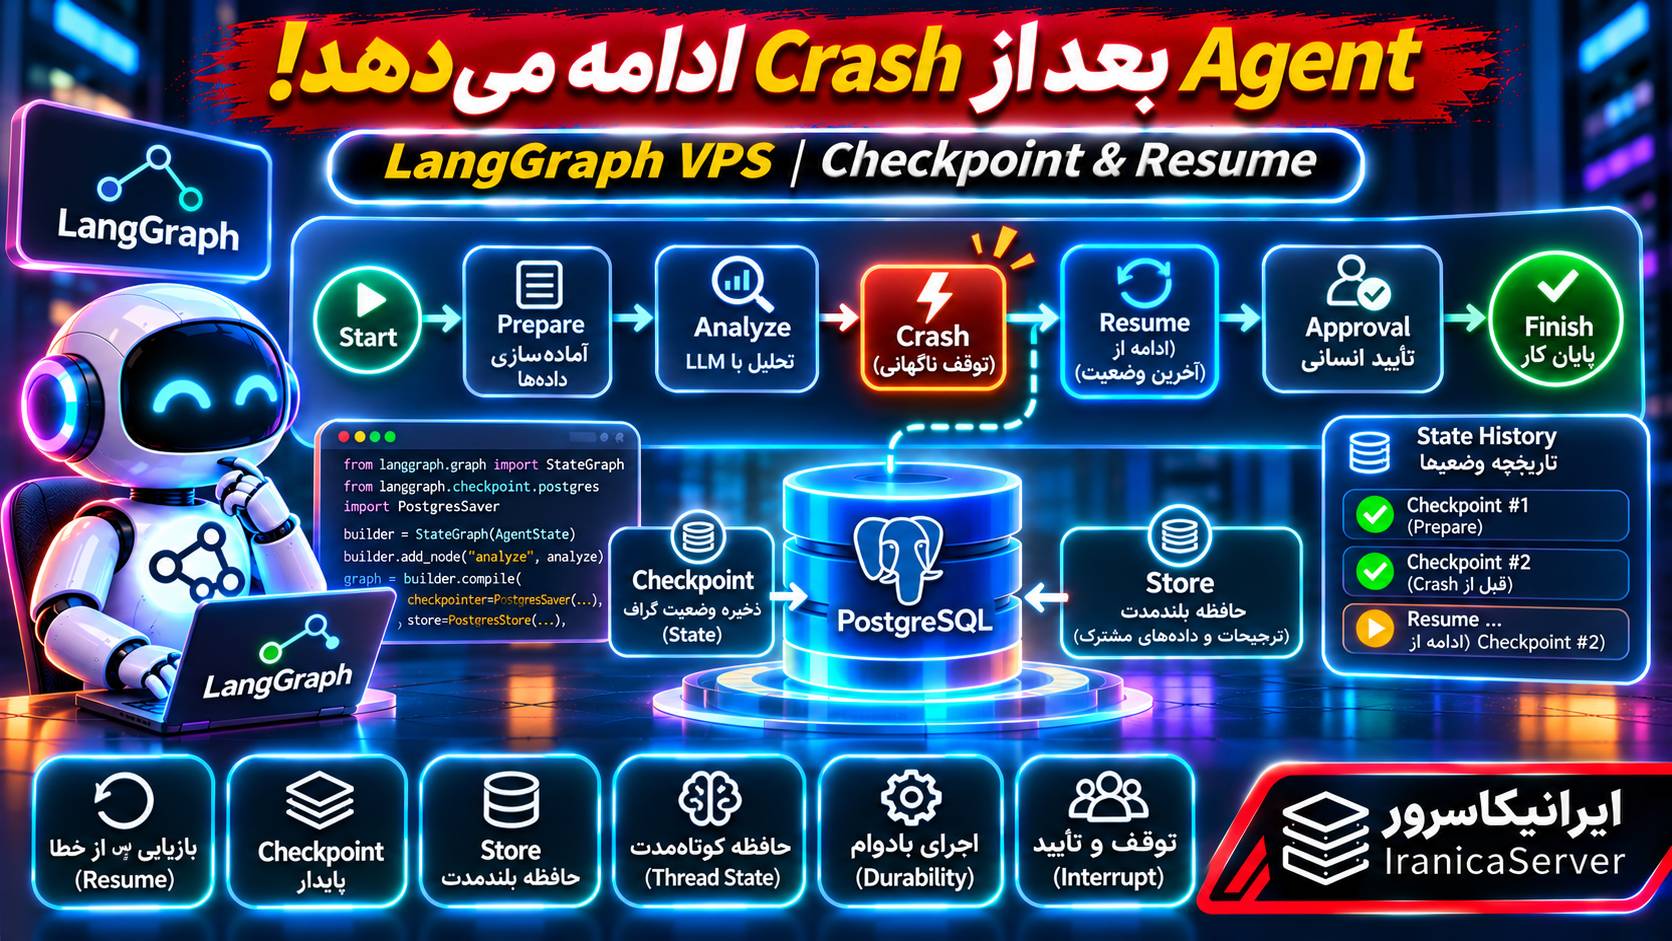
در LangGraph، حافظه کوتاهمدت معمولاً داخل State همان Thread نگهداری میشود و Checkpointer میتواند این State را در دیتابیس ذخیره کند.
Long-Term Memory؛ حافظه میان چند گفتگو
حافظه بلندمدت اطلاعاتی را نگهداری میکند که ممکن است بعد از پایان گفتگوی فعلی نیز ارزش استفاده داشته باشند.
مثلاً:
- ترجیح کاربر به پاسخهای کوتاه.
- فرمت ثابت گزارش موردنظر یک سازمان.
- نکتهای تأییدشده درباره یک پروژه.
- نتیجه و درس آموختهشده از یک اجرای قبلی.
این حافظه معمولاً با شناسه کاربر، سازمان یا یک Namespace مشخص مدیریت میشود و به یک Thread محدود نیست.
| ویژگی | Short-Term | Long-Term |
|---|---|---|
| محدوده | گفتگو یا Thread | کاربر، سازمان یا برنامه |
| داده نمونه | پیامهای اخیر | ترجیحات و دانش ماندگار |
| روش بازیابی | بر اساس Thread ID | بر اساس Owner، Namespace و نیاز کار |
| زمان نگهداری | متناسب با عمر گفتگو | متناسب با نوع اطلاعات |
| خطر اصلی | افزایش Context و نشت بین گفتگوها | قدیمی شدن، برداشت اشتباه و نقض حریم خصوصی |
| راهکار نمونه | Session یا Checkpointer | Store یا دیتابیس حافظه مستقل |
نکته: Short-Term به معنی نگهداری فقط در RAM نیست. حافظه کوتاهمدت نیز میتواند روی دیسک ذخیره شود و پس از Restart باقی بماند. تفاوت اصلی این دو نوع حافظه، محدوده و هدف استفاده از اطلاعات است؛ نه صرفاً محل ذخیرهسازی.
Semantic، Episodic و Procedural Memory چه تفاوتی دارند؟
حافظه بلندمدت را میتوان براساس نوع اطلاعات به چند دسته تقسیم کرد.
۱. Semantic Memory؛ حافظه دانستهها و واقعیتها
Semantic Memory شامل اطلاعاتی است که به شکل یک واقعیت، ترجیح یا دانش قابل بیان ذخیره میشوند.
برای مثال:
- کاربر گزارشهای مختصر را ترجیح میدهد.
- نام پروژه آزمایشی، Demo VPS است.
- زبان پاسخهای یک سازمان باید فارسی باشد.
برای این نوع حافظه معمولاً ثبت یک Key مشخص و مقدار آن مفید است؛ چون امکان اصلاح اطلاعات را ساده میکند.
۲. Episodic Memory؛ حافظه رویدادها و تجربهها
Episodic Memory اطلاعات مربوط به اتفاقهایی را نگهداری میکند که در زمان مشخصی رخ دادهاند.
برای مثال:
- در تاریخ مشخص، یک گزارش تولید و بررسی شد.
- Agent در اجرای آزمایشی با خطای Timeout مواجه شد.
- مدیر یک درخواست مشخص را رد کرد.
در این نوع حافظه، زمان، منبع و نتیجه رویداد اهمیت زیادی دارند.
۳. Procedural Memory؛ قواعد و شیوه انجام کار
Procedural Memory به دستورالعملها و قواعد انجام وظایف اشاره دارد.
برای مثال، یک برنامه ممکن است قاعده داشته باشد که پیش از Restart سرویس، وضعیت کاربران متصل بررسی شود.
اما در سیستمهای دارای عملیات حساس، دستورالعملهای اجرایی نباید صرفاً با یک خاطره تولیدشده توسط مدل تغییر کنند.
بهتر است سیاستهای امنیتی و قواعد دارای مجوز در کد یا تنظیمات نسخهبندیشده و مورد اعتماد نگهداری شوند.
| نوع حافظه | نمونه | پیشنهاد ذخیرهسازی |
|---|---|---|
| Semantic | ترجیح سبک پاسخ | Key/Value با نسخه و منبع |
| Episodic | نتیجه اجرای یک Job | رکورد رویداد با Timestamp |
| Procedural | قواعد انجام عملیات | سیاست نسخهبندیشده و قابل تأیید |
تفاوت Semantic Memory و Semantic Search
این دو اصطلاح شبیهاند، اما یکسان نیستند.
Semantic Memory نوع اطلاعات ذخیرهشده را توصیف میکند؛ Semantic Search روشی برای جستوجو براساس شباهت معنایی است.
برای مثال، میتوان ترجیح «پاسخ کوتاه» را در جدول رابطهای ذخیره کرد، بدون اینکه برای آن Embedding ساخته شود.
از طرف دیگر، میتوان رویدادهای Episodic را نیز Embedding کرد و در آنها جستوجوی معنایی انجام داد.
معماری پیشنهادی حافظه Agent روی VPS
برای جداسازی صحیح حافظه، بهتر است یک لایه مدیریت Memory بین Agent و دیتابیس وجود داشته باشد.
User / Application
        |
Authentication + Owner Scope
        |
      AI Agent
        |
  Memory Policy Layer
        |
  +-----+----------------+
  |                      |
Short-Term            Long-Term
  |                      |
Thread Messages       Semantic Facts
Recent Context        Episodic Events
  |                      |
  +---------+------------+
            |
      Retrieval Gate
  Owner + TTL + Freshness
            |
    Relational Database
            |
 Optional Vector Index
            |
   Verified Memory Context
لایه Memory Policy چه کاری انجام میدهد؟
این لایه تصمیم میگیرد اطلاعات در کدام مخزن ثبت شوند، چه مدت اعتبار داشته باشند و چه کسی اجازه مشاهده یا اصلاح آنها را داشته باشد.
همچنین باید پیش از بازیابی، منقضی نبودن اطلاعات و مجوز دسترسی را بررسی کند.
چرا Agent نباید مستقیماً تمام دیتابیس را بخواند؟
اگر مدل به یک ابزار جستوجوی نامحدود دسترسی داشته باشد، ممکن است خاطرات مربوط به کاربران دیگر یا دادههای غیرضروری را دریافت کند.
Backend باید Owner ID و محدوده مجوز را از احراز هویت معتبر تعیین کند و فقط اطلاعات مربوط به همان محدوده را برگرداند.
چه اطلاعاتی را در حافظه Agent ذخیره کنیم؟
هر جملهای که در گفتگو مطرح میشود، لزوماً ارزش تبدیل شدن به حافظه بلندمدت ندارد.
برای مثال، یک سؤال موقت درباره وضعیت لحظهای سرور معمولاً نباید برای همیشه بهعنوان حقیقت ذخیره شود.
اطلاعات مناسب برای نگهداری بلندمدت
- ترجیحات صریح و نسبتاً پایدار کاربر.
- تنظیمات انتخابشده برای یک پروژه.
- تصمیمهای ثبتشده و تأییدشده.
- خلاصه تجربههای اجرایی با شناسه Job.
- اطلاعاتی که کاربر اجازه نگهداری آنها را داده است.
اطلاعاتی که نباید بیدلیل ذخیره شوند
- رمز عبور و API Key.
- Cookie و Session Token.
- کدهای یکبارمصرف ورود.
- اطلاعات شخصی یا حساس غیرضروری.
- متن کامل هر گفتگوی کوتاه و بیاهمیت.
- نتایج موقت و تأییدنشده مدل.
در صورت نیاز به Credential، بهتر است از Secret Manager استفاده شود. سیستم حافظه نباید به جای محل امن نگهداری رمزها به کار رود.
چگونه اطلاعات را به حافظه بلندمدت تبدیل کنیم؟
یکی از اشتباهات رایج این است که مدل بدون کنترل، هر چیزی را که مفید تشخیص داد وارد Long-Term Memory کند.
راه بهتر، ایجاد یک مسیر مشخص برای ثبت خاطره است.
مرحله اول: استخراج اطلاعات پیشنهادی
Agent میتواند از گفتگو یک گزاره پیشنهادی استخراج کند؛ مثلاً «کاربر پاسخ کوتاه میخواهد».
مرحله دوم: بررسی منبع
باید مشخص شود این اطلاعات مستقیماً توسط کاربر بیان شدهاند، از یک ابزار معتبر آمدهاند یا صرفاً برداشت مدل هستند.
مرحله سوم: بررسی حساسیت
اگر داده شامل اطلاعات محرمانه یا شخصی غیرضروری باشد، نباید بدون سیاست مناسب ذخیره شود.
مرحله چهارم: تعیین نوع و زمان اعتبار
اطلاعات باید در یکی از دستههای Semantic یا Episodic قرار بگیرند و زمان انقضا و اعتبارسنجی داشته باشند.
مرحله پنجم: ثبت کنترلشده
در نمونه عملی این مقاله، ثبت خاطره با فرمان صریح اپراتور انجام میشود. مدل زبانی اختیار نوشتن خودکار در دیتابیس ندارد.
برای محصول واقعی میتوان یک Tool محدود ساخت که فقط پس از بررسی هویت، مجوز و سیاست داده اجازه ذخیره اطلاعات مناسب را بدهد.
TTL در حافظه Agent چیست و چه زمانی استفاده میشود؟
TTL مخفف Time To Live است؛ یعنی مدت زمانی که یک داده اجازه نگهداری یا استفاده دارد.
برای مثال، ممکن است پیامهای یک گفتگوی آزمایشی پس از دو روز حذف شوند، اما یک ترجیح کاربر تا زمان مشخصی معتبر بماند.
TTL برای انواع مختلف اطلاعات
| نوع اطلاعات | TTL شروع پیشنهادی | توضیح |
|---|---|---|
| پیامهای موقت آزمایشی | ۲ روز | در صورت نبود نیاز طولانیتر |
| رویداد اجرای آزمایشی | ۷ روز | با توجه به نیاز Debug و Audit |
| ترجیح قابل تغییر کاربر | ۳۰ روز | همراه با بررسی دورهای اعتبار |
| وضعیت لحظهای سرویس | بسیار کوتاه یا بدون حافظه بلندمدت | بهتر است از منبع زنده خوانده شود |
| داده دارای الزام نگهداری | طبق سیاست رسمی مربوطه | نه براساس یک مقدار عمومی ثابت |
این زمانها نمونه سیاست آموزشیاند و مقدار استاندارد ثابتی برای تمام پروژهها محسوب نمیشوند.
تفاوت انقضای منطقی و حذف فیزیکی
ممکن است یک رکورد از نظر TTL منقضی شده باشد، اما هنوز داخل فایل دیتابیس وجود داشته باشد.
در این حالت، برنامه باید از بازگرداندن آن در جستوجو جلوگیری کند و یک فرآیند پاکسازی نیز برای حذف فیزیکی رکوردها داشته باشد.
همچنین داده منقضی ممکن است در Backupهای قدیمی موجود باشد؛ بنابراین سیاست حذف باید نسخههای پشتیبان را نیز در نظر بگیرد.
Stale Memory چیست و چگونه از اطلاعات قدیمی جلوگیری کنیم؟
Stale Memory به اطلاعاتی گفته میشود که ممکن است همچنان در حافظه وجود داشته باشند، اما اعتبار یا تازگی آنها دیگر قابل اتکا نباشد.
برای مثال، Agent هفته گذشته از یک ابزار خوانده است که سرویس demo-vps-01 آنلاین است. این اطلاعات یک رویداد تاریخی معتبر محسوب میشود؛ اما نباید وضعیت آنلاین بودن سرویس در لحظه فعلی را ثابت کند.
تفاوت expires_at و verified_until
در نمونه عملی، برای هر خاطره دو زمان مجزا داریم:
- expires_at: زمان پایان نگهداری یا قابلیت استفاده رکورد.
- verified_until: زمانی که پس از آن، اطلاعات برای استفاده مجدد به تأیید تازه نیاز دارند.
مثلاً ممکن است یک خاطره تا ۳۰ روز در دیتابیس باقی بماند، اما اعتبار عملی آن پس از ۷ روز نیازمند بازبینی باشد.
چگونه خاطره قدیمی را اصلاح کنیم؟
برای دادههای Semantic بهتر است یک Key ثابت داشته باشید. در این صورت، وقتی کاربر ترجیح خود را تغییر میدهد، میتوان مقدار جدید را به جای مقدار قبلی ثبت کرد.
برای رویدادهای Episodic معمولاً بهتر است تجربه قبلی حفظ شود و رویداد تازهای اضافه گردد؛ زیرا اتفاق گذشته با تغییر شرایط فعلی لزوماً نادرست نمیشود.
اگر دو منبع با یکدیگر اختلاف داشتند چه کنیم؟
باید منبع، تاریخ و سطح اعتبار هر داده بررسی شود. در اطلاعات عملیاتی حساس، بهتر است از API یا دیتابیس اصلی سیستم استعلام جدید انجام شود.
شباهت معنایی بالا یا اعتماد مدل به یک خاطره، دلیل کافی برای حل اختلاف دادهها نیست.
برای حافظه Agent از دیتابیس رابطهای استفاده کنیم یا برداری؟
انتخاب Relational Database یا Vector Database باید براساس روش جستوجو و نوع داده انجام شود.
Relational Database؛ مناسب اطلاعات ساختاریافته
SQLite و PostgreSQL برای دادههایی مناسباند که Key مشخص، نوع، مالک، زمان انقضا و روابط قابل تعریف دارند.
برای مثال، اگر میخواهید مقدار preference.answer_style یک کاربر را پیدا کنید، یک Query رابطهای معمولاً کافی است.
Vector Database؛ مناسب جستوجوی مبتنی بر معنا
اگر تعداد زیادی خاطره متنی دارید و سؤال کاربر الزاماً از همان واژههای ذخیرهشده استفاده نمیکند، جستوجوی برداری میتواند مفید باشد.
برای مثال، کاربر میپرسد «دفعه قبل درباره کندی سرور چه مشکلی داشتیم؟» و سیستم به دنبال رویدادی با عباراتی مانند CPU Saturation یا High Load میگردد.
مقایسه کاربردی
| معیار | Relational | Vector |
|---|---|---|
| جستوجوی Key دقیق | مناسب | غیرضروری |
| فیلتر Owner و TTL | قوی و مستقیم | نیازمند Metadata Filtering |
| جستوجوی معنایی متن | محدود بدون ابزار اضافی | مناسب |
| تضمین درست بودن اطلاعات | خیر | خیر |
| تراکنش و اصلاح رکورد | مناسب | بسته به سیستم |
| هزینه Embedding | لازم نیست | معمولاً نیاز دارد |
| پیچیدگی عملیاتی | معمولاً کمتر | بیشتر، در صورت افزودن Index و مدل Embedding |
آیا باید دو دیتابیس مستقل نصب کنیم؟
خیر. PostgreSQL با افزونه pgvector میتواند دادههای رابطهای و Embeddingها را در یک سیستم نگهداری کند.
برای بسیاری از پروژهها این ترکیب، نقطه شروع مناسبی است؛ زیرا میتوان فیلترهای مالکیت، اعتبار و نوع حافظه را کنار جستوجوی برداری اعمال کرد.
Embedding چیست و در بازیابی حافظه چه کاربردی دارد؟
Embedding نمایش عددی یک متن است که میتوان از آن برای اندازهگیری شباهت معنایی استفاده کرد.
برای مثال، عبارتهای «پاسخ کوتاه میخواهم» و «توضیحات را خلاصه بنویس» ممکن است از نظر معنایی نزدیک باشند، حتی اگر واژههای یکسان کمی داشته باشند.
Embedding میتواند به پیدا کردن چنین اطلاعاتی کمک کند.
ساخت Embedding با OpenAI API
نمونه کد Python:
from openai import OpenAI
client = OpenAI()
response = client.embeddings.create(
model="text-embedding-3-small",
input="کاربر پاسخهای کوتاه را ترجیح میدهد",
)
vector = response.data[0].embedding
print(len(vector))مدل text-embedding-3-small بهصورت پیشفرض برداری با ۱۵۳۶ بُعد تولید میکند. در مدلهای نسل سوم میتوان با پارامتر dimensions اندازه بردار را نیز تغییر داد.
آیا Embedding حاوی اطلاعات خصوصی است؟
بردارها متن اصلی نیستند، اما نباید آنها را داده کاملاً بیخطر یا ناشناس فرض کرد.
Embeddings میتوانند اطلاعاتی درباره محتوای اولیه منتقل کنند و در بعضی سناریوها برای استنباط اطلاعات حساس استفاده شوند.
بنابراین مالکیت، کنترل دسترسی، حذف و نگهداری آنها باید مانند سایر اطلاعات مرتبط با کاربران طراحی شود.
آیا Embedding ثابت میکند یک خاطره درست است؟
خیر. شباهت بالا فقط نشان میدهد دو متن از نظر نمایش برداری به یکدیگر نزدیکاند.
اطلاعات نادرست، قدیمی یا مربوط به کاربر دیگر نیز ممکن است شباهت معنایی بالایی با سؤال داشته باشند.
برای اجرای AI Agent Memory چه VPS نیاز داریم؟
برای نمونه عملی این مقاله، Python و SQLite کافی هستند. نیازی به GPU یا نصب مدل زبانی محلی نداریم.
| سناریو | RAM اولیه پیشنهادی | CPU اولیه پیشنهادی |
|---|---|---|
| نمونه Python و SQLite | ۱ تا ۲ گیگابایت | ۱ vCPU |
| API حافظه با PostgreSQL | ۲ تا ۴ گیگابایت | ۲ vCPU |
| PostgreSQL همراه pgvector | ۴ تا ۸ گیگابایت | ۲ تا ۴ vCPU |
| حجم زیاد Embedding و کاربران همزمان | براساس تست بار | براساس اندازه Index و Queryها |
این اعداد، برآورد اولیه هستند و حداقل رسمی کتابخانهها محسوب نمیشوند. نیاز واقعی به تعداد خاطرات، Indexها، حجم داده و تعداد Queryهای همزمان بستگی دارد.
برای حافظه برداری بزرگ، فضای ذخیرهسازی و RAM کافی میتوانند تأثیر زیادی بر عملکرد جستوجو داشته باشند.
مرحله اول: نصب پروژه AI Agent Memory روی Ubuntu VPS
در این آموزش از Ubuntu 24.04 LTS استفاده میکنیم.
نصب Python
sudo apt update

sudo apt install -y \
python3 \
python3-venv \
python3-pip
ساخت پوشه پروژه
mkdir -p ~/agent-memory

cd ~/agent-memory
فایل memory.py موجود در بسته دانلودی مقاله را داخل این پوشه قرار دهید.
ساخت محیط مجازی اختیاری
python3 -m venv .venv

.venv/bin/python --version
نمونه اصلی فقط از کتابخانههای استاندارد Python استفاده میکند و برای اجرای آن به OpenAI API Key یا نصب کتابخانه خارجی نیاز ندارید.
تنظیم مسیر دیتابیس
export MEMORY_DB="$PWD/agent-memory.sqlite3"در محیط Production بهتر است دیتابیس در مسیری با مالکیت و مجوزهای محدود مانند /var/lib یک سرویس اختصاصی قرار بگیرد.
مرحله دوم: طراحی دیتابیس برای انواع حافظه
در پروژه عملی، حافظه کوتاهمدت و بلندمدت در دو جدول مستقل ذخیره میشوند.
جدول messages
این جدول پیامهای یک Thread را همراه مالک، نقش پیام، زمان ثبت و انقضا نگهداری میکند.
CREATE TABLE IF NOT EXISTS messages (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    owner TEXT NOT NULL,
    thread TEXT NOT NULL,
    role TEXT NOT NULL,
    content TEXT NOT NULL,
    created_at TEXT NOT NULL,
    expires_at TEXT NOT NULL
);
جدول memories
در جدول حافظه بلندمدت، علاوه بر متن خاطره، نوع، منبع و زمان اعتبار آن ذخیره میشود.
CREATE TABLE IF NOT EXISTS memories (
    id TEXT PRIMARY KEY,
    owner TEXT NOT NULL,
    kind TEXT NOT NULL,
    memory_key TEXT NOT NULL,
    content TEXT NOT NULL,
    source TEXT NOT NULL,
    confidence REAL NOT NULL,
    created_at TEXT NOT NULL,
    updated_at TEXT NOT NULL,
    expires_at TEXT NOT NULL,
    verified_until TEXT NOT NULL,
    status TEXT NOT NULL,
    UNIQUE(owner, kind, memory_key)
);
در سورس کامل، محدودیتهای CHECK، Indexها، تراکنشها و جدول Audit نیز تعریف شدهاند.
چرا owner اهمیت دارد؟
چون حافظه کاربر اول نباید در جستوجوی کاربر دوم نمایش داده شود.
در نمونه CLI، مقدار owner توسط اپراتور وارد میشود؛ اما در API عمومی این شناسه باید از احراز هویت معتبر استخراج شود، نه از یک پارامتر دلخواه کلاینت.
ایجاد جداول
.venv/bin/python memory.py initبعد از اجرا، فایل دیتابیس SQLite ساخته میشود.
مرحله سوم: پیادهسازی Short-Term Memory
ابتدا یک پیام برای کاربر آزمایشی و Thread مشخص ذخیره میکنیم.
.venv/bin/python memory.py say \
--owner demo-user \
--thread conversation-01 \
--role user \
--text "لطفاً پاسخ را کوتاه بنویس" \
--ttl-days 2
این پیام در جدول messages ذخیره میشود و پس از دو روز، از Queryهای معتبر خارج خواهد شد.
بازیابی پیامهای اخیر
.venv/bin/python memory.py recent \
--owner demo-user \
--thread conversation-01 \
--limit 8
برنامه فقط پیامهای معتبر همان Owner و همان Thread را برمیگرداند.
چرا تعداد پیامها را محدود میکنیم؟
زیرا ارسال کل تاریخچه بلندمدت به مدل ممکن است Context را بزرگ، پاسخ را کند و هزینه Token را افزایش دهد.
در محصول واقعی میتوان پیامهای اخیر را همراه با خلاصه معتبر بخشهای قدیمیتر استفاده کرد.
نکته مهم این است که خلاصه تولیدشده توسط مدل نیز باید از نظر دقت و حریم خصوصی کنترل شود.
مرحله چهارم: ذخیره Semantic و Episodic Memory
حالا یک ترجیح نسبتاً پایدار را در حافظه بلندمدت ثبت میکنیم.
ثبت Semantic Memory
.venv/bin/python memory.py remember \
--owner demo-user \
--kind semantic \
--key answer_style \
--text "پاسخ کوتاه و دقیق" \
--source "explicit user preference" \
--ttl-days 30 \
--verify-days 7
این خاطره با Key مشخص ذخیره میشود. استفاده از Key ثابت باعث میشود اگر ترجیح کاربر تغییر کرد، بتوان اطلاعات را اصلاح کرد.
ثبت Episodic Memory
.venv/bin/python memory.py remember \
--owner demo-user \
--kind episodic \
--text "گزارش آزمایشی سرور بررسی و تأیید شد" \
--source "demo job event" \
--ttl-days 7 \
--verify-days 7
برای خاطره Episodic، پروژه یک شناسه مستقل ایجاد میکند؛ زیرا رویدادهای مختلف ممکن است متنهای مشابه داشته باشند، اما همچنان اتفاقهای جداگانهای باشند.
چه تفاوتی در ثبت وجود دارد؟
Semantic Memory برای اصلاح یک دانسته یا ترجیح طراحی شده است، درحالیکه Episodic Memory تاریخچه رویدادها را نگهداری میکند.
این جداسازی کمک میکند تغییر ترجیح امروز باعث حذف بیدلیل تاریخچه یک اتفاق قدیمی نشود.
مرحله پنجم: بازیابی حافظه با کنترل Owner و زمان اعتبار
اکنون میتوانیم اطلاعات معتبر را از دیتابیس بخوانیم.
.venv/bin/python memory.py recall \
--owner demo-user \
--query "پاسخ"
نمونه پروژه از جستوجوی متنی ساده استفاده میکند. بنابراین فقط رکوردهایی پیدا میشوند که عبارت موردنظر با متن ذخیرهشده تطابق داشته باشد.
این روش Semantic Search واقعی نیست؛ اما برای نشان دادن جداسازی مالک، TTL و Freshness کافی است.
Query اصلی بازیابی
SELECT
    kind,
    memory_key,
    content,
    source,
    confidence
FROM memories
WHERE owner = ?
  AND status = 'active'
  AND expires_at > ?
  AND verified_until > ?
  AND content LIKE ?
ORDER BY updated_at DESC
LIMIT 5;
این Query پیش از بازیابی، سه شرط مهم را بررسی میکند: مالکیت، پایان نیافتن TTL و معتبر بودن زمان آخرین تأیید اطلاعات.
آیا confidence به معنی احتمال واقعی درست بودن است؟
لزوماً خیر. در این نمونه confidence صرفاً یک فیلد ثبتشده است.
اگر بخواهید آن را بهعنوان احتمال واقعی صحت تفسیر کنید، باید روش تولید و کالیبراسیون آن را با دادههای معتبر آزمایش کنید.
در طراحی Production بهتر است منبع، تازگی و تأیید مستقل، وزن بیشتری از اعتماد اعلامشده توسط خود مدل داشته باشند.
مرحله ششم: اصلاح اطلاعات، حذف خاطره و اجرای TTL
حافظهای که قابل اصلاح یا حذف نباشد، در بلندمدت مشکلساز خواهد شد.
اصلاح Semantic Memory
فرض کنید کاربر ترجیح پاسخ خود را تغییر داده است.
.venv/bin/python memory.py remember \
--owner demo-user \
--kind semantic \
--key answer_style \
--text "پاسخ خلاصه و همراه مثال" \
--source "explicit user correction"
چون Key برابر answer_style است، مقدار قبلی همین خاطره بهروزرسانی میشود.
حذف یک خاطره مشخص
.venv/bin/python memory.py forget \
--owner demo-user \
--kind semantic \
--key answer_style
این دستور رکورد مربوط به حافظه را از دیتابیس فعال حذف میکند.
پاکسازی خاطرات منقضیشده
.venv/bin/python memory.py cleanupاین دستور رکوردهایی را که TTL آنها تمام شده از جداول فعال حذف میکند.
حذف اطلاعات یک Owner
.venv/bin/python memory.py purge \
--owner demo-user
این عملیات مخرب است و فقط باید در محیط مجاز انجام شود.
همچنین حذف از دیتابیس فعال بهمعنی حذف خودکار اطلاعات از Backupها، Logهای دیگر یا سرویسهای خارجی نیست. برای محصول واقعی باید فرآیند حذف کامل دادهها براساس محلهای ذخیرهسازی طراحی شود.
پیادهسازی حافظه برداری با PostgreSQL و pgvector
اگر حجم خاطرات متنی زیاد شود و به جستوجوی معنایی نیاز داشته باشید، میتوانید از PostgreSQL همراه pgvector استفاده کنید.
pgvector قابلیت ذخیره Embedding و جستوجوی نزدیکترین بردارها را در PostgreSQL فراهم میکند.
فعال کردن افزونه
پس از نصب افزونه متناسب با نسخه PostgreSQL، میتوانید آن را در دیتابیس موردنظر فعال کنید:
CREATE EXTENSION IF NOT EXISTS vector;این دستور فرض میکند بسته pgvector قبلاً روی PostgreSQL نصب شده و حساب اجرایی مجوز لازم را دارد.
ساخت جدول ترکیبی حافظه
CREATE TABLE agent_memories (
    id UUID PRIMARY KEY,
    owner_id TEXT NOT NULL,
    memory_type TEXT NOT NULL,
    content TEXT NOT NULL,
    source TEXT NOT NULL,
    expires_at TIMESTAMPTZ NOT NULL,
    verified_until TIMESTAMPTZ NOT NULL,
    embedding vector(1536)
);

CREATE INDEX agent_memories_owner_idx
ON agent_memories(owner_id);
عدد ۱۵۳۶ در این مثال با ابعاد پیشفرض text-embedding-3-small مطابقت دارد. اگر مدل یا مقدار dimensions را تغییر دهید، باید ساختار ستون و Index نیز سازگار باشد.
جستوجوی مشابهترین خاطرات معتبر
SELECT id, content, source
FROM agent_memories
WHERE owner_id = $1
  AND expires_at > NOW()
  AND verified_until > NOW()
  AND embedding IS NOT NULL
ORDER BY embedding <=> $2::vector
LIMIT 5;
پارامتر اول Owner معتبر است و پارامتر دوم بردار سؤال کاربر را شامل میشود.
این Query فقط برای نشان دادن الگوی جستوجو است. برنامه باید ابتدا هویت کاربر را بررسی کند و پارامترها را بهصورت امن به Query منتقل کند.
Index نوع HNSW
برای مجموعههای بزرگتر، میتوان Index تقریبی ایجاد کرد:
CREATE INDEX agent_memories_hnsw_idx
ON agent_memories
USING hnsw (embedding vector_cosine_ops);
HNSW میتواند سرعت جستوجو را افزایش دهد، اما جستوجوی آن تقریبی است و ممکن است نسبت به جستوجوی دقیق، بعضی نتایج را بازیابی نکند.
نکته امنیتی درباره Owner Filtering
در pgvector، هنگام استفاده از Indexهای تقریبی ممکن است فیلترها پس از بخشی از جستوجوی Index اعمال شوند. این موضوع میتواند تعداد نتایج را کاهش دهد.
برای سامانه چندکاربره باید هم صحت فیلتر مالکیت و هم Recall را آزمایش کنید. در مجموعههای بزرگ، Partitioning یا Indexهای مناسب برای Tenantها میتوانند مفید باشند.
اما بهینهسازی Index جایگزین کنترل دسترسی دیتابیس و Backend نیست.
چگونه خاطرات بازیابیشده را رتبهبندی کنیم؟
یک سیستم حافظه حرفهای نباید صرفاً اولین نتیجه مشابه را به مدل ارسال کند.
برای انتخاب حافظه مناسب میتوان چند معیار را ترکیب کرد:
- ارتباط خاطره با درخواست فعلی.
- معتبر بودن Owner و Scope.
- تازه بودن اطلاعات.
- منبع و قابلیت تأیید.
- نوع خاطره و میزان ارتباط آن با هدف کار.
- تکراری نبودن اطلاعات.
نمونه فرمول رتبهبندی مفهومی
برای یک پروژه آزمایشی میتوان از امتیاز ترکیبی استفاده کرد:
\(\text{Score} = 0.5R + 0.3F + 0.2S\)
در این فرمول، R نشاندهنده ارتباط معنایی، F تازگی و S امتیاز منبع معتبر است.
ضرایب بالا صرفاً نمونه آموزشی هستند و نباید بدون آزمایش بهعنوان فرمول عمومی استفاده شوند.
همچنین فیلترهای امنیتی و انقضا باید قبل از رتبهبندی اعمال شوند. یک خاطره غیرمجاز، حتی با امتیاز ارتباط بالا، نباید وارد نتایج شود.
آیا میتوان خاطرات متناقض را همزمان به مدل فرستاد؟
گاهی برای توضیح تاریخچه تغییرات لازم است؛ اما باید زمان و منبع هر خاطره مشخص باشد.
اگر هدف پاسخ به وضعیت فعلی است، بهتر است منبع جدید و معتبر بررسی شود و تعارض به کاربر پنهان نماند.
حریم خصوصی در AI Agent Memory چگونه حفظ میشود؟
حافظه بلندمدت میتواند اطلاعات زیادی درباره کاربران، پروژهها و رفتارهای گذشته ذخیره کند؛ بنابراین طراحی آن باید با حداقلسازی داده و کنترل دسترسی همراه باشد.
۱. جداسازی اطلاعات کاربران
هر رکورد باید دارای مالک مشخص باشد و در زمان بازیابی فقط اطلاعات مجاز همان مالک نمایش داده شوند.
در سامانههای چندسازمانی باید علاوه بر User ID، محدوده Tenant یا Organization نیز بررسی شود.
۲. ذخیره نکردن اطلاعات غیرضروری
اگر هدف فقط ثبت ترجیح زبان پاسخ است، نیازی نیست متن کامل گفتگو یا اطلاعات تماس کاربر نیز ذخیره شود.
۳. محافظت از Secrets
رمز عبور، Token و کلیدهای API نباید بهعنوان Memory معمولی ثبت شوند.
اگر Agent برای انجام کار به Credential نیاز دارد، باید آن را از سیستم مدیریت Secret دریافت کند و مجوز دسترسی محدود داشته باشد.
۴. حذف و اصلاح اطلاعات
کاربران یا اپراتورهای مجاز باید بتوانند خاطرات نادرست را اصلاح و اطلاعاتی را که دیگر لازم نیست حذف کنند.
در محصول واقعی، حذف داده باید Storeهای فعال، Cacheها، Embeddingها، نسخههای پشتیبان و سرویسهای پردازشگر مربوطه را نیز در نظر بگیرد.
۵. محافظت از Embeddingها
Embeddingها نباید بهصورت عمومی منتشر شوند یا بدون کنترل دسترسی در اختیار کاربران دیگر قرار گیرند.
حتی اگر متن اصلی از پایگاه داده حذف شود، باید نسخه برداری مرتبط نیز طبق سیاست حذف اصلاح شود.
۶. کنترل ارسال داده به API خارجی
اگر برای ساخت Embedding یا پاسخگویی از یک API خارجی استفاده میکنید، محتوای ارسالی باید مطابق سیاست محرمانگی، مجوز کاربر و شرایط پردازش داده باشد.
قبل از ارسال اطلاعات حساس، سیاست نگهداری و پردازش ارائهدهنده را بررسی کنید.
۷. جلوگیری از Memory Poisoning
ممکن است محتوای یک صفحه وب، ایمیل یا سند خارجی تلاش کند اطلاعات نادرست یا دستورهای مخرب را به حافظه بلندمدت وارد کند.
برای مقابله با این مشکل، ثبت حافظه باید منبع، سطح اعتماد و مجوز مشخص داشته باشد.
متن یک سند خارجی نباید بتواند سیاست اجرایی Agent یا سطح دسترسی ابزارها را تغییر دهد.
چگونه حافظه را به LangGraph متصل کنیم؟
اگر از LangGraph استفاده میکنید، میتوانید حافظه کوتاهمدت را با Checkpointer و حافظه بلندمدت را با Store مدیریت کنید.
برای مثال:
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.store.memory import InMemoryStore

checkpointer = InMemorySaver()
store = InMemoryStore()

graph = builder.compile(
    checkpointer=checkpointer,
    store=store,
)
این نمونه برای توسعه مناسب است؛ زیرا هر دو محل ذخیرهسازی در حافظه RAM قرار دارند.
برای Production باید از Backend پایدار مانند PostgreSQL استفاده کنید و چرخه عمر اتصال و Migrationها را مدیریت کنید.
ذخیره یک ترجیح در Store
store.put(
    ("users", "demo-user", "preferences"),
    "answer_style",
    {"value": "short"},
)
بازیابی در Thread جدید
item = store.get(
    ("users", "demo-user", "preferences"),
    "answer_style",
)

if item is not None:
    print(item.value)
این نمونه تفاوت محدوده Thread و حافظه میان گفتگوها را نشان میدهد.
اما Store بهتنهایی تمام سیاستهای TTL، حریم خصوصی، اعتبار اطلاعات و تأیید منبع را برای برنامه شما طراحی نمیکند.
برای این موارد باید در لایه برنامه سیاست مشخص داشته باشید. همچنین در پروژههایی که به Semantic Search نیاز دارند، میتوانید Index و مدل Embedding را به Store اضافه کنید.
جزئیات نصب LangGraph و PostgresStore در مقاله آموزش LangGraph روی VPS با Checkpoint و PostgreSQL بررسی شده است.
چگونه AI Agent Memory را در Production روی VPS اجرا کنیم؟
نمونه اصلی این مقاله یک برنامه CLI آموزشی است و هنوز API عمومی یا سرویس چندکاربره محسوب نمیشود.
برای تبدیل آن به محصول واقعی باید چند لایه اضافی پیادهسازی کنید.
API احراز هویتشده
هر درخواست ثبت یا بازیابی حافظه باید به کاربر معتبر مرتبط باشد. Owner ID نباید صرفاً از ورودی آزاد کاربر دریافت شود.
سیاست دسترسی به نوع حافظه
ممکن است یک کاربر اجازه مشاهده ترجیحات شخصی خود را داشته باشد، اما حق مشاهده Audit سازمان یا رویدادهای کاربران دیگر را نداشته باشد.
جلوگیری از ثبت خودکار اطلاعات حساس
اگر Agent مجوز ساخت حافظه جدید دارد، پیشنهادهای آن باید از فیلترهای سیاستی و در صورت نیاز تأیید انسان عبور کنند.
مدیریت TTL
برای پاکسازی فیزیکی دادههای منقضی میتوانید از systemd Timer یا مکانیزم زمانبندی موجود در زیرساخت استفاده کنید.
برای مثال، فرمان زیر میتواند توسط Timer اجرا شود:
/opt/agent-memory/.venv/bin/python \
/opt/agent-memory/memory.py cleanup
این فقط نمونه مسیر است و باید با محل نصب واقعی پروژه هماهنگ شود.
همچنین متغیر MEMORY_DB باید برای سرویس Timer به درستی تنظیم شده باشد.
Backup و Restore
برای SQLite بهتر است از Backup API یا سازوکار سازگار با WAL استفاده شود. کپی کردن تنها فایل اصلی دیتابیس در زمان فعالیت Writer ممکن است نسخه ناقص ایجاد کند.
برای PostgreSQL نیز میتوانید از pg_dump و روشهای پشتیبانگیری مناسب استفاده کنید.
بااینحال باید اطلاعات حذفشده کاربران و سیاست Retention را در طراحی Backup لحاظ کنید.
مانیتورینگ کیفیت حافظه
علاوه بر CPU و RAM، شاخصهای زیر را اندازهگیری کنید:
- تعداد خاطرات فعال و منقضی.
- نرخ بازیابی خاطرات مرتبط.
- تعداد خاطرات اصلاحشده یا حذفشده.
- درصد خاطرات قدیمی که پیش از پاسخ رد میشوند.
- زمان متوسط جستوجوی حافظه.
- مصرف Token مربوط به Context حافظه.
- موارد بازیابی اشتباه بین کاربران.
- نرخ اطلاعات غیرقابل تأیید در پاسخ Agent.
چه تستهایی برای حافظه Agent ضروری هستند؟
پیش از استفاده واقعی، باید رفتار حافظه را در شرایط عادی و خطا بررسی کنید.
| تست | نتیجه مورد انتظار |
|---|---|
| ثبت پیام در Thread | فقط در همان Thread بازیابی شود |
| ثبت Semantic Memory | در گفتگوهای مجاز بعدی قابل استفاده باشد |
| ثبت Episodic Memory | با زمان و منبع مستقل ذخیره شود |
| تغییر ترجیح کاربر | مقدار قبلی Semantic اصلاح شود |
| پایان TTL | رکورد منقضی در Recall نمایش داده نشود |
| پایان verified_until | اطلاعات نیازمند تأیید دوباره شود |
| درخواست کاربر دیگر | حافظه Owner اول نمایش داده نشود |
| حذف یک خاطره | از جستوجوی فعال خارج شود |
| حذف تمام حافظه یک کاربر | رکوردهای مربوطه از دیتابیس فعال حذف شوند |
| ورود اطلاعات مخرب | به دستور مورد اعتماد Agent تبدیل نشود |
| بازیابی چند نتیجه برداری | Scope و Freshness قبل از نمایش رعایت شوند |
تست ضد نشت اطلاعات
دو Owner آزمایشی با اطلاعات متفاوت بسازید. سپس بررسی کنید آیا Recall کاربر دوم میتواند اطلاعات کاربر اول را ببیند یا خیر.
در نمونه CLI، Queryهای اصلی owner را فیلتر میکنند. برای Production باید همین محدودیت در لایه احراز هویت و مجوز نیز اعمال شود.
تست خاطره قدیمی
یک رکورد با زمان اعتبار گذشته بسازید یا در محیط آزمایشی مقدار verified_until را منقضی کنید.
نتیجه مورد انتظار این است که خاطره در بازیابی معمولی نمایش داده نشود تا اطلاعات دوباره تأیید شوند.
تست اصلاح حافظه
یک ترجیح Semantic ثبت و سپس با همان Key مقدار جدیدی ذخیره کنید.
پس از اصلاح، مقدار قدیمی نباید بهعنوان ترجیح فعال در Recall بازگردد.
تست Memory Poisoning
در محیط ایزوله، متنی آزمایشی وارد کنید که ادعا میکند سیاست Agent باید تغییر کند.
این متن نباید بتواند مجوز ابزارها یا System Prompt مورد اعتماد را تغییر دهد؛ حتی اگر داخل حافظه یا داده بازیابیشده ظاهر شود.
اشتباهات رایج در طراحی AI Agent Memory
۱. ذخیره تمام پیامها بهعنوان حافظه بلندمدت
این روش باعث افزایش حجم، تکرار اطلاعات و خطر نقض حریم خصوصی میشود. فقط اطلاعات مناسب و دارای ارزش مشخص را به Long-Term Memory منتقل کنید.
۲. استفاده از حافظه قدیمی بهعنوان وضعیت فعلی
وضعیت سرور، قیمت، موجودی و اطلاعات متغیر باید در صورت نیاز از منبع معتبر دوباره بررسی شوند.
۳. استفاده از Vector Similarity بهعنوان معیار حقیقت
شباهت بالا نشاندهنده صحت اطلاعات نیست. منبع و زمان اعتبار باید مستقل بررسی شوند.
۴. نبود Owner Scope
این مشکل ممکن است باعث افشای خاطرات کاربران مختلف شود. شناسه مالک باید در Query و کنترل مجوز وجود داشته باشد.
۵. ثبت رمز عبور در حافظه
Credentialها نباید بهعنوان Memory معمولی ذخیره شوند. از سیستم مدیریت Secrets استفاده کنید.
۶. نداشتن TTL
بدون سیاست نگهداری، حافظه ممکن است بهصورت نامحدود رشد کند. TTL باید متناسب با نوع اطلاعات تعریف شود.
۷. حذف منطقی بدون پاکسازی
فیلتر کردن رکورد منقضی از نتایج کافی نیست. برای حذف فیزیکی و مدیریت Backup نیز سیاست مشخص لازم است.
۸. اشتباه گرفتن Session State و Long-Term Memory
اطلاعات یک Thread نباید بدون دلیل برای تمام گفتگوهای بعدی همان کاربر استفاده شوند.
۹. ثبت خاطره بر اساس حدس مدل
اطلاعات استنباطی نباید بدون مشخص کردن منبع و سطح اطمینان، به حقیقت قطعی تبدیل شوند.
۱۰. استفاده از Procedural Memory برای تغییر مجوزها
قواعد امنیتی و ابزارهای حساس باید از کد و سیاست مورد اعتماد کنترل شوند؛ نه از خاطرات قابل تغییر توسط مدل.
۱۱. نادیده گرفتن هزینه Embedding
اگر تمام پیامها و فایلها بهصورت پیوسته Embedding شوند، هزینه API و اندازه Index میتواند افزایش پیدا کند. ابتدا نیاز واقعی جستوجوی معنایی را اندازهگیری کنید.
۱۲. نداشتن برنامه اصلاح اطلاعات
حافظه باید امکان تغییر دانستههای نادرست و ثبت منبع جدید را داشته باشد.
۱۳. نبود تست کیفیت Retrieval
ممکن است جستوجو از نظر فنی موفق باشد، اما خاطره نامناسبی برگرداند. ارزیابی Precision، Recall و مرتبط بودن پاسخ اهمیت دارد.
۱۴. ارسال بیرویه حافظه به مدل
بهتر است فقط تعداد محدودی خاطره واقعاً مرتبط به Prompt اضافه شود. افزایش Context همیشه باعث افزایش کیفیت نمیشود.
سؤالات متداول درباره AI Agent Memory
AI Agent Memory چیست؟
سیستمی برای ذخیره، بازیابی، اصلاح و مدیریت اطلاعات موردنیاز Agent در گفتگوها و اجرای وظایف مختلف است.
Short-Term Memory چیست؟
حافظهای است که اطلاعات گفتگوی جاری یا یک Thread را نگهداری میکند؛ مانند پیامهای اخیر و وضعیت مراحل.
Long-Term Memory چیست؟
حافظهای است که اطلاعات مفید را میان چند گفتگو یا اجرای مستقل نگهداری میکند.
آیا Short-Term Memory فقط در RAM ذخیره میشود؟
خیر. میتواند با Checkpointer یا دیتابیس روی دیسک ذخیره شود. تفاوت اصلی در محدوده استفاده از داده است.
Semantic Memory چیست؟
نوعی حافظه برای ذخیره دانستهها، واقعیتها و ترجیحات قابل بیان است.
Episodic Memory چیست؟
نوعی حافظه برای ثبت اتفاقها و تجربههای گذشته همراه با زمان و زمینه وقوع آنها است.
Procedural Memory چیست؟
حافظه مربوط به قواعد و شیوه انجام کار است. در سیستمهای حساس باید از سیاستهای اجرایی مورد اعتماد جدا شود.
تفاوت Semantic Memory و Semantic Search چیست؟
Semantic Memory نوع اطلاعات است؛ Semantic Search روش پیدا کردن دادههای مشابه از نظر معناست.
آیا برای Agent Memory به Vector Database نیاز داریم؟
خیر. بسیاری از خاطرات ساختاریافته را میتوان در SQLite یا PostgreSQL معمولی ذخیره کرد.
چه زمانی Vector Database مفید است؟
زمانی که تعداد زیادی خاطره متنی دارید و بازیابی بر اساس معنا از جستوجوی دقیق بهتر عمل میکند.
آیا pgvector برای حافظه Agent مناسب است؟
بله. میتواند Embeddingها را همراه با دادههای رابطهای در PostgreSQL نگهداری کند.
Embedding چیست؟
نمایش عددی متن است که برای محاسبه شباهت معنایی و جستوجوی برداری استفاده میشود.
آیا شباهت برداری به معنی درست بودن اطلاعات است؟
خیر. شباهت معنایی فقط ارتباط احتمالی متنها را نشان میدهد، نه اعتبار یا تازگی آنها.
TTL در حافظه Agent چیست؟
مدت اعتبار یا نگهداری داده است که پس از آن رکورد باید از استفاده خارج یا طبق سیاست حذف شود.
Stale Memory چیست؟
خاطرهای است که هنوز ذخیره شده اما ممکن است به دلیل گذشت زمان یا تغییر شرایط دیگر معتبر نباشد.
چگونه اطلاعات قدیمی را مدیریت کنیم؟
با ثبت منبع، زمان انقضا، زمان آخرین اعتبارسنجی و استعلام دوباره دادههای متغیر.
آیا میتوان حافظه اشتباه را اصلاح کرد؟
بله. بهتر است دادههای Semantic دارای Key مشخص و مسیر اصلاح کنترلشده باشند.
آیا Episodic Memory باید همیشه حذف شود؟
خیر. مدت نگهداری به هدف ثبت رویداد، نیاز Audit و سیاست محرمانگی بستگی دارد.
چگونه از نشت حافظه میان کاربران جلوگیری کنیم؟
با احراز هویت معتبر، Owner Scope، کنترل مجوز Backend و فیلتر صحیح Queryها.
آیا Embeddingها اطلاعات خصوصی محسوب میشوند؟
ممکن است اطلاعاتی درباره داده اولیه منتقل کنند؛ بنابراین باید با کنترل دسترسی و سیاست حفاظت مناسب مدیریت شوند.
آیا باید API Key را در حافظه Agent ذخیره کنیم؟
خیر. API Key باید در سیستم مدیریت Secrets نگهداری شود.
آیا LangGraph از حافظه کوتاهمدت و بلندمدت پشتیبانی میکند؟
بله. Checkpointer برای State هر Thread و Store برای اطلاعات بلندمدت میان Threadها استفاده میشود.
آیا InMemoryStore برای Production مناسب است؟
برای توسعه و تست مفید است؛ اما برای نگهداری داده پس از Restart باید از Backend پایدار استفاده کنید.
آیا یک Agent میتواند خودش خاطره جدید بسازد؟
از نظر فنی بله؛ اما بهتر است ثبت خاطره تحت سیاست منبع، مجوز، حساسیت و اعتبارسنجی انجام شود.
چگونه Memory Poisoning را کاهش دهیم؟
با غیرقابل اعتماد دانستن محتوای خارجی، کنترل مسیر نوشتن حافظه و جلوگیری از تبدیل خاطرات به دستورات سیستمی.
آیا افزایش حافظه باعث پاسخ بهتر میشود؟
نه لزوماً. حافظه نامرتبط یا قدیمی میتواند دقت را کاهش دهد و هزینه پردازش را افزایش دهد.
آیا Agent Memory روی VPS قابل اجرا است؟
بله. میتوانید مدیریت حافظه را با Python، SQLite یا PostgreSQL روی VPS اجرا کنید.
آیا برای حافظه برداری GPU لازم است؟
اگر Embedding از طریق API تولید شود، معمولاً برای خود برنامه نیازی به GPU محلی نیست.
برای پروژه کوچک SQLite بهتر است یا PostgreSQL؟
SQLite برای نمونه کوچک و یک سرور ساده است؛ PostgreSQL برای توسعه چندکاربره و جستوجوی پیچیدهتر انعطاف بیشتری دارد.
جمعبندی
طراحی درست AI Agent Memory به این معنی نیست که تمام گفتگوها را برای همیشه ذخیره کنیم. باید مشخص باشد هر اطلاعات به چه کاری میآید، متعلق به چه کسی است، از کدام منبع دریافت شده و تا چه زمانی معتبر خواهد بود.
در این آموزش تفاوت Short-Term و Long-Term Memory را بررسی کردیم و توضیح دادیم که حافظه بلندمدت میتواند شامل Semantic، Episodic و Procedural Memory باشد.
همچنین با Python و SQLite یک نمونه عملی ساختیم که پیامهای کوتاهمدت را براساس Thread ذخیره میکند، خاطرات معنایی و رویدادی را جدا نگه میدارد، زمان اعتبار را کنترل میکند و امکان اصلاح یا حذف دادهها را فراهم میکند.
در مرحله بعد دیدیم که Vector Database برای تمام پروژهها ضروری نیست. اگر به جستوجوی معنایی در حجم زیاد خاطرات نیاز دارید، PostgreSQL و pgvector میتوانند در کنار فیلترهای رابطهای انتخاب مناسبی باشند.
بااینحال، شباهت برداری جایگزین بررسی حقیقت، تازگی و مجوز دسترسی نیست. هر خاطره باید پیش از استفاده از نظر Owner، TTL، منبع و ارتباط با درخواست فعلی بررسی شود.
اصل نهایی: حافظه مفید برای Agent، حافظهای نیست که بیشترین داده را ذخیره کند؛ بلکه حافظهای است که اطلاعات درست و مجاز را در زمان مناسب بازیابی کند و بتوان دادههای قدیمی یا نادرست آن را اصلاح یا حذف کرد.
اگر میخواهید این معماری را با LangGraph و PostgreSQL ترکیب کنید، راهنمای آموزش LangGraph روی VPS با Checkpoint و Store را نیز مطالعه کنید. برای طراحی بازیابی وضعیت اجرای Agent پس از Restart نیز مقاله AI Agent Persistence و Crash Recovery مفید است.
منابع و مستندات رسمی
۱. LangGraph — Memory Overview
معرفی حافظه کوتاهمدت و بلندمدت و تفاوت Semantic، Episodic و Procedural Memory.
۲. LangGraph — Add and Manage Memory
روش مدیریت Short-Term Memory، Store و بازیابی اطلاعات در گراف.
راهنمای مدیریت حافظه LangGraph
۳. LangGraph — Persistence
توضیح Checkpointer، Thread State و حافظه بلندمدت با Store.
۴. OpenAI — Vector Embeddings
راهنمای رسمی تولید Embedding، ابعاد بردار و کاربرد جستوجوی معنایی.
۵. OpenAI — Create Embeddings API
مرجع پارامترهای API و پشتیبانی از dimensions.
۶. pgvector — GitHub
راهنمای جستوجوی برداری، HNSW، IVFFlat و Metadata Filtering در PostgreSQL.
۷. PostgreSQL — Row Security Policies
راهنمای جداسازی رکوردها با Row-Level Security در دیتابیس چندکاربره.
۸. SQLite — WAL
راهنمای دوام داده و مدیریت همزمانی در SQLite.
۹. OWASP — Sensitive Information Disclosure
ریسک افشای اطلاعات حساس در سیستمهای هوش مصنوعی و روشهای کاهش خطر.
۱۰. OWASP — AI Agent Security
توصیههای امنیتی درباره دسترسی ابزارها، اطلاعات غیرقابل اعتماد و محافظت از Agent.
دیدگاهها (۰)