
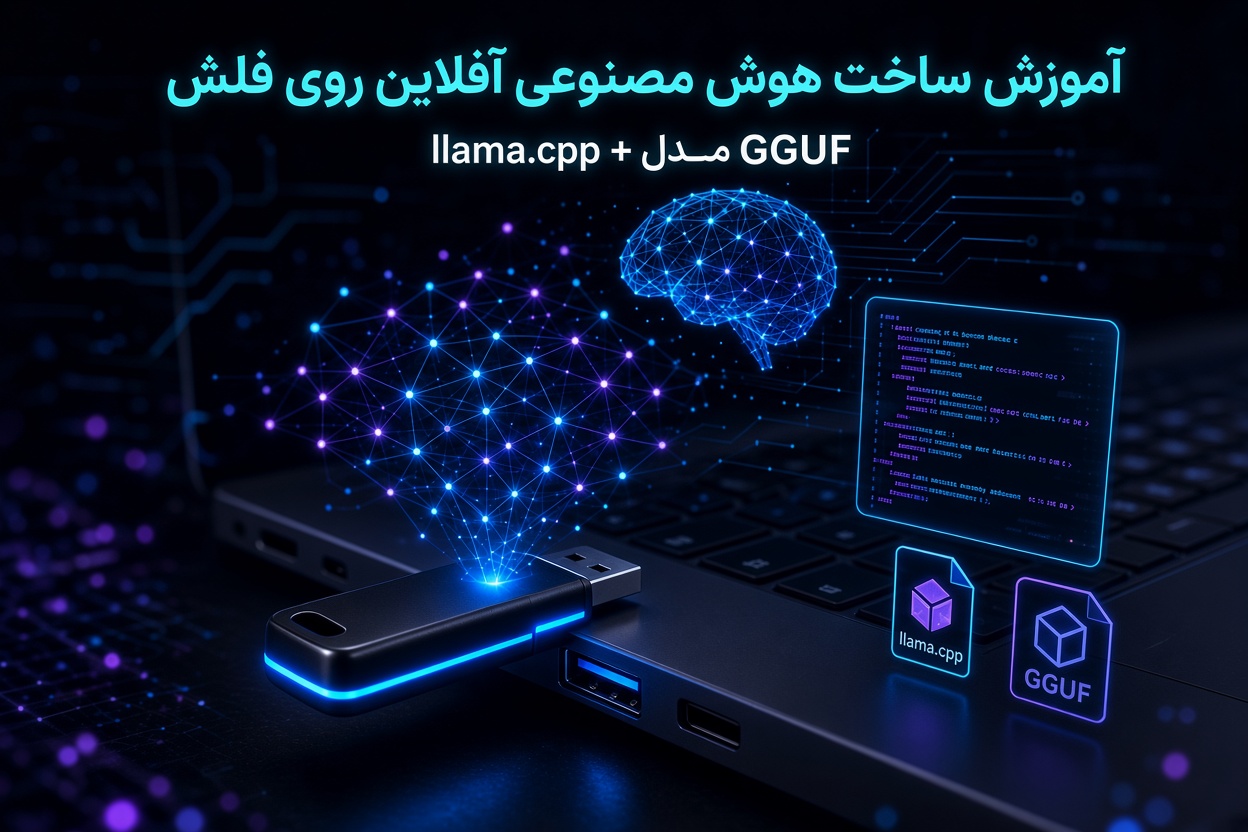
آموزش ساخت هوش مصنوعی آفلاین روی فلش با llama.cpp و مدل GGUF؛ یک AI پرتابل واقعی
برای داشتن یک هوش مصنوعی شخصی، همیشه لازم نیست مرورگر را باز کنید و به یک سرویس آنلاین متصل شوید. میتوان مدل هوش مصنوعی را روی فلش USB یا SSD اکسترنال قرار داد و آن را مستقیماً روی کامپیوتر اجرا کرد؛ بدون اینکه برای هر سؤال به یک سرویس ابری متصل شوید.
در این آموزش، قدمبهقدم یک هوش مصنوعی آفلاین و پرتابل با llama.cpp میسازیم. موتور اجرای مدل و فایل GGUF روی حافظه قابل حمل قرار میگیرند و بعد از آمادهسازی اولیه، میتوانید AI را مستقیماً از همان حافظه اجرا کنید.
📌 پاسخ سریع: برای ساخت AI آفلاین روی فلش به یک نسخه مناسب llama.cpp، یک مدل با فرمت GGUF و حافظه USB یا SSD اکسترنال نیاز دارید. پس از دانلود فایلها، اجرای مدل میتواند کاملاً روی سیستم محلی انجام شود و برای چت عادی با مدل نیازی به ارسال درخواست به یک سرویس هوش مصنوعی آنلاین ندارید.
در نمونه این آموزش از یک مدل کوچک Gemma 3 1B Instruct استفاده میکنیم. مزیت مدل کوچک این است که برای شروع به سختافزار بسیار قدرتمندی احتیاج نداریم و حتی میتوان فایل Quantized آن را با حجم کمتر از یک گیگابایت روی حافظه قابل حمل نگه داشت.
هوش مصنوعی پرتابل روی فلش دقیقاً چگونه کار میکند؟
قبل از شروع یک سوءبرداشت رایج را برطرف کنیم: فلش USB خودش هوش مصنوعی را اجرا نمیکند. فلش فقط محل نگهداری فایل مدل و برنامه اجراکننده است. محاسبات همچنان توسط CPU، RAM و در صورت استفاده از شتابدهی سختافزاری، GPU کامپیوتری که فلش به آن متصل شده انجام میشوند.
پس وقتی از «هوش مصنوعی روی فلش» صحبت میکنیم، منظورمان یک محیط قابل حمل است. بهجای نصب دوباره مدل و ابزارهای مورد نیاز روی هر کامپیوتر، فایلها را همراه خود داریم و روی سیستم سازگار اجرا میکنیم.
این روش چه مزیتهایی دارد؟
🔹 امکان اجرای مدل بدون اتصال دائمی به اینترنت
🔹 نگهداری مدلها روی حافظه قابل حمل
🔹 عدم نیاز به نصب محیطهای سنگین برای هر بار استفاده
🔹 امکان نگهداری چند مدل GGUF در یک حافظه
🔹 مناسب برای آزمایش مدلهای متنباز و Local AI
🔹 کنترل بیشتر روی دادههایی که به مدل میدهید
برای ساخت AI آفلاین روی فلش به چه چیزهایی نیاز داریم؟
پیادهسازی این پروژه پیچیده نیست. مهمترین تصمیم، انتخاب مدل متناسب با سختافزار است. اگر مدل بیش از ظرفیت RAM سیستم باشد، پرتابل بودن آن عملاً کمکی به شما نمیکند.
🔹 فلش USB پرسرعت یا ترجیحاً SSD اکسترنال
🔹 سیستم ویندوز ۶۴ بیتی سازگار
🔹 نسخه مناسب llama.cpp
🔹 یک مدل هوش مصنوعی با فرمت GGUF
🔹 RAM کافی متناسب با مدل
🔹 اینترنت برای دانلود اولیه فایلهای مورد نیاز
فلش USB بهتر است یا SSD اکسترنال؟
برای مدل کوچک میتوانید از یک فلش USB مناسب استفاده کنید. اما اگر قصد دارید مدلهای چند گیگابایتی یا چند مدل مختلف را همراه خود نگه دارید، SSD اکسترنال انتخاب بهتری است. سرعت حافظه بیشتر از همه هنگام خواندن و بارگذاری اولیه فایل مدل احساس میشود.
llama.cpp چیست و چرا برای AI پرتابل مناسب است؟
llama.cpp یک پروژه متنباز برای اجرای مدلهای زبانی روی سختافزار محلی است. یکی از نقاط قوت آن این است که میتوان بسیاری از مدلهای GGUF را بدون راهاندازی یک محیط پیچیده Python اجرا کرد.
این ویژگی برای پروژه ما اهمیت زیادی دارد. هدف این است که پوشه llama.cpp و فایل مدل را روی حافظه قرار دهیم و تا جای ممکن وابستگی به نصب نرمافزارهای متعدد روی کامپیوتر مقصد را کاهش دهیم.
llama.cpp علاوه بر اجرای مدل با CPU، بسته به سختافزار و Build انتخابشده امکان استفاده از شتابدهیهایی مانند CUDA، Vulkan و ROCm را نیز فراهم میکند. برای یک مجموعه پرتابل عمومی، نسخه CPU معمولاً شروع سادهتری است؛ ولی برای سیستم مشخص و قدرتمند میتوان سراغ Build متناسب با GPU رفت.
GGUF چیست و Q4، Q5 و Q8 چه معنایی دارند؟
اگر در Hugging Face بهدنبال مدلهای قابل اجرا با llama.cpp بگردید، بارها با پسوند GGUF مواجه میشوید. GGUF فرمتی مناسب برای توزیع و اجرای مدلها در اکوسیستم llama.cpp است و مدلهای Quantized زیادی با این فرمت منتشر میشوند.
Quantization به زبان ساده یعنی کاهش دقت عددی وزنهای مدل با هدف کم کردن حجم و مصرف حافظه. نتیجه این است که مدل بزرگ را میتوان در نسخههای سبکتر ارائه کرد؛ البته هرچه فشردهسازی شدیدتر شود، ممکن است بخشی از کیفیت مدل نیز تحت تأثیر قرار بگیرد.
| نوع تقریبی | مصرف حافظه | کیفیت نسبی | کاربرد پیشنهادی |
|---|---|---|---|
| Q4 / IQ4 | کمتر | متعادل | شروع کار و سختافزار محدود |
| Q5 | متوسط | بالاتر | تعادل کیفیت و منابع |
| Q8 | بیشتر | نزدیکتر به مدل اصلی | سیستم دارای RAM بیشتر |
⚠️ نکته: این جدول یک راهنمای کلی است، نه قانون ثابت برای تمام مدلها. اندازه واقعی فایل و کیفیت Quantization به مدل، روش Quantize و نوع فایل بستگی دارد. قبل از دانلود، توضیحات همان مخزن مدل را بررسی کنید.
مرحله اول: ساخت پوشههای AI روی فلش
فلش یا SSD اکسترنال را متصل کنید و یک پوشه با نام دلخواه بسازید. برای مثال:
Portable-AIداخل آن دو پوشه برای موتور اجرا و مدلها ایجاد کنید:
Portable-AI
|
+-- llama
|
+-- models
این ساختار یک مزیت ساده ولی مهم دارد: بعداً میتوانید چند فایل GGUF را داخل پوشه models قرار دهید و همه آنها را با همان مجموعه llama.cpp اجرا کنید.
مرحله دوم: دانلود llama.cpp برای ویندوز
به صفحه رسمی Releases پروژه بروید و Build مناسب سیستم خود را دریافت کنید. برای این آموزش، اگر هدفتان اجرای ساده و قابل حمل است، نسخه متناسب با ویندوز و سختافزار سیستم را انتخاب کنید.
فایل فشرده را استخراج کنید و محتویات آن را در پوشه llama قرار دهید. در Build مربوطه فایلهای اجرایی مورد نیاز را خواهید داشت که دو مورد مهم برای ما llama-cli.exe و llama-server.exe هستند.
llama-cli برای اجرای مدل از خط فرمان مناسب است. llama-server نیز مدل را به شکل یک سرویس محلی اجرا میکند و امکان استفاده از رابط وب و API محلی را فراهم میکند.
مرحله سوم: دانلود مدل Gemma 3 1B با فرمت GGUF
برای آزمایش اولیه بهتر است سراغ مدل کوچکی برویم که اجرای آن روی سیستمهای معمولی منطقیتر باشد. در آموزش مبنا، از خانواده Gemma 3 1B Instruct استفاده شده و فایل نمونه زیر یک Quantization سبک است:
gemma-3-1b-it-IQ4_NL.ggufخانواده Gemma توسط Google ارائه شده و نسخههای GGUF مناسب llama.cpp از طریق مخازن مختلف Hugging Face در دسترس هستند. هنگام دانلود حتماً نام فایل، اندازه، Quantization و توضیحات Repository را بررسی کنید.
فایل GGUF دانلودشده را داخل پوشه models قرار دهید تا ساختار نهایی تقریباً به شکل زیر باشد:
Portable-AI
|
+-- llama
|   +-- llama-cli.exe
|   +-- llama-server.exe
|   +-- ...
|
+-- models
    +-- gemma-3-1b-it-IQ4_NL.gguf
مرحله چهارم: اجرای هوش مصنوعی آفلاین
CMD یا Windows Terminal را در پوشه Portable-AI باز کنید. سپس فایل مدل را با llama-cli اجرا کنید:
llama\llama-cli.exe -m "models\gemma-3-1b-it-IQ4_NL.gguf"پارامتر -m مسیر فایل مدل را مشخص میکند. llama.cpp مدل را از حافظه میخواند و در صورت وجود منابع کافی، آن را بارگذاری میکند. پس از آماده شدن محیط تعاملی میتوانید Prompt خود را وارد کنید.
⚠️ اگر مدل اجرا نشد: ابتدا نام و مسیر فایل GGUF را بررسی کنید. بعد مطمئن شوید Build صحیح llama.cpp را دانلود کردهاید و RAM سیستم برای مدل کافی است. دانلود یک مدل بسیار بزرگ برای سیستمی با حافظه محدود یکی از رایجترین دلایل شکست در اجرای Local AI است.
چطور AI واقعاً پرتابل باشد؟ مسیر ثابت نسازید
فرض کنید فلش روی کامپیوتر شما درایو E است. اگر تمام دستورها را با مسیر E بنویسید، ممکن است روی کامپیوتر دیگری فلش با حرف F یا G شناسایی شود و اسکریپت کار نکند.
برای حل این مشکل بهتر است از مسیرهای نسبی استفاده کنیم. این موضوع هنگام ساخت فایل BAT اهمیت بیشتری پیدا میکند.
ساخت فایل BAT برای اجرای AI با دو کلیک
برای هر بار اجرا لازم نیست CMD باز کنید و دستور بنویسید. در پوشه Portable-AI یک فایل با نام run-ai.bat بسازید و کد زیر را داخل آن قرار دهید:
@echo off
cd /d "%~dp0"
llama\llama-cli.exe -m "models\gemma-3-1b-it-IQ4_NL.gguf"
pause
عبارت %~dp0 باعث میشود اسکریپت ابتدا به محل خود فایل BAT برود. در نتیجه اگر حرف درایو فلش روی سیستم دیگر تغییر کند، مسیرهای نسبی همچنان شانس بیشتری برای کار کردن دارند.
از AI آفلاین شخصی تا هوش مصنوعی همیشهروشن روی VPS
فلش برای یک هوش مصنوعی شخصی و قابل حمل انتخاب جالبی است؛ اما اگر بخواهید مدل شما ۲۴ ساعته روشن باشد، از چند دستگاه به آن دسترسی داشته باشید یا یک API هوش مصنوعی برای پروژه خود بسازید، اجرای مدل روی سرور انتخاب متفاوتی است.
در ایرانیکاسرور میتوانید پلنهای سرور مجازی ایران را از نظر CPU و RAM بررسی و متناسب با مدل مورد نظرتان انتخاب کنید. برای Local LLM باید قبل از خرید، منابع مورد نیاز همان مدل را در نظر بگیرید؛ مدلهای بزرگتر RAM بیشتری میخواهند و بعضی کاربردها ممکن است به GPU نیاز داشته باشند.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور
اجرای هوش مصنوعی در مرورگر با llama-server
اگر محیط خط فرمان را برای گفتگو مناسب نمیدانید، llama.cpp ابزار دیگری به نام llama-server دارد. با آن میتوان مدل را بهصورت یک سرویس محلی اجرا کرد.
llama\llama-server.exe -m "models\gemma-3-1b-it-IQ4_NL.gguf" --host 127.0.0.1 --port 8080پس از بارگذاری مدل، در تنظیم بالا سرویس فقط روی Loopback سیستم گوش میدهد. سپس میتوانید آدرس زیر را در مرورگر همان کامپیوتر باز کنید:
http://127.0.0.1:8080وجود کلمه «Web» در این روش به معنی ارسال اطلاعات به یک وبسایت خارجی نیست. مرورگر در اینجا فقط رابط کاربری سرویسی را نمایش میدهد که روی کامپیوتر خودتان اجرا شده است.
فایل BAT برای رابط تحت وب
@echo off
cd /d "%~dp0"
llama\llama-server.exe -m "models\gemma-3-1b-it-IQ4_NL.gguf" --host 127.0.0.1 --port 8080
pause
آیا بعد از دانلود مدل واقعاً میتوان اینترنت را قطع کرد؟
برای سناریوی ساده این آموزش، بله. وقتی فایل اجرایی llama.cpp و مدل GGUF روی حافظه شما هستند، Inference مدل روی همان سیستم انجام میشود و برای تولید پاسخ معمولی لازم نیست Prompt به سرویس AI خارجی ارسال شود.
حتی میتوانید پس از آمادهسازی مجموعه، اینترنت را قطع و مدل را آزمایش کنید. این یکی از سادهترین روشها برای اطمینان از Local بودن سناریوی پایه است.
اما آفلاین بودن محدودیت هم دارد. مدل نمیتواند خودش خبرهای امروز یا اطلاعات جدید وب را بداند. پاسخ آن بر اساس اطلاعات موجود در مدل و Contextی است که شما در اختیارش میگذارید.
چطور چند مدل هوش مصنوعی روی یک فلش داشته باشیم؟
هیچ الزامی وجود ندارد که فقط Gemma را نگه دارید. میتوانید چند مدل GGUF سازگار داشته باشید و برای هرکدام یک فایل BAT بسازید.
models
|
+-- small-model.gguf
+-- general-model.gguf
+-- coding-model.gguf
+-- multilingual-model.gguf
برای مثال میتوانید یک مدل سبک برای لپتاپ ضعیف، یک مدل عمومی برای سیستم اصلی و یک مدل مخصوص برنامهنویسی داشته باشید. تنها محدودیت اصلی فضای حافظه و توان سیستم میزبان است.
برای مدلهای مختلف تقریباً چقدر RAM لازم داریم؟
نمیتوان تنها بر اساس تعداد پارامترها یک عدد قطعی برای RAM اعلام کرد؛ Quantization، Context، معماری مدل و تنظیمات اجرا هم مؤثرند. جدول زیر فقط برای درک بهتر مقیاس مدلهاست و باید قبل از دانلود، اندازه واقعی فایل GGUF و توضیحات همان مدل را بررسی کنید.
| اندازه مدل | سناریوی معمول | پیشنهاد عملی |
|---|---|---|
| حدود ۱B تا ۳B | مدلهای سبک و آزمایشی | مناسب برای شروع و سیستمهای معمولی |
| حدود ۷B تا ۸B | مدل عمومی قویتر | اندازه GGUF و RAM آزاد را دقیق بررسی کنید |
| مدلهای بزرگتر | کار حرفهایتر | نیازمند منابع بیشتر و انتخاب دقیق سختافزار |
📌 نکته مهم: حجم فایل GGUF حداقل خوبی برای تخمین اولیه است، اما RAM مصرفی هنگام اجرا الزاماً دقیقاً برابر حجم فایل نیست. Context و Bufferهای اجرایی نیز حافظه مصرف میکنند.
CPU یا GPU؛ کدام برای llama.cpp بهتر است؟
اگر هدف اصلی شما قابلیت حمل بین کامپیوترهای مختلف باشد، اجرای CPU سادهتر است؛ چون نمیدانید سیستم بعدی دقیقاً چه GPU و Driverهایی دارد.
اما اگر قرار است مدل همیشه روی یک سیستم مشخص اجرا شود، استفاده از Build و Backend متناسب با GPU میتواند سرعت تولید Token را به شکل محسوسی تغییر دهد. برای مثال، در سیستم مجهز به GPU سازگار NVIDIA میتوان Build مناسب CUDA را بررسی کرد.
در نتیجه «بهترین نسخه» یک پاسخ ثابت ندارد: برای AI پرتابل عمومی، سازگاری اهمیت بیشتری دارد؛ برای AI ثابت روی یک سیستم قدرتمند، سرعت میتواند اولویت بالاتری داشته باشد.
آیا Local AI برای اطلاعات خصوصی امنتر است؟
در سناریوی کاملاً محلی، Prompt برای Inference معمولی به سرویس ابری عمومی ارسال نمیشود. این موضوع برای اسناد داخلی یا متنهایی که نمیخواهید مستقیماً در سرویسهای عمومی AI وارد شوند، مزیت مهمی است.
با این حال Local بودن به معنی امنیت مطلق نیست. اگر کامپیوتر آلوده باشد، فلش گم شود یا اطلاعات حساس را بدون رمزنگاری ذخیره کنید، همچنان امکان افشای داده وجود دارد. امنیت دستگاه و نحوه نگهداری فایلها همچنان اهمیت دارد.
خطاهای رایج در اجرای AI از روی فلش
مدل پیدا نمیشود
نام فایل و مسیر models را کنترل کنید. اگر نام فایل GGUF را تغییر دادهاید، همان نام جدید باید در دستور یا فایل BAT نوشته شود.
مدل هنگام Load بسته میشود
یکی از احتمالات کمبود حافظه است. ابتدا با یک مدل کوچکتر یا Quantization سبکتر آزمایش کنید و خروجی خطای llama.cpp را بخوانید.
پاسخدهی بسیار کند است
کندی میتواند به CPU، اندازه مدل، Quantization، طول Context یا Backend انتخابشده مربوط باشد. یک مدل کوچکتر را اجرا کنید تا مشخص شود محدودیت اصلی سختافزار است یا تنظیمات.
فایل BAT روی سیستم دیگر کار نمیکند
از مسیر ثابت وابسته به حرف درایو استفاده نکنید. ساختار پوشهها را حفظ کنید و از مسیر نسبی استفاده کنید.
مدل AI روی سرور اجرا نمیشود یا برای انتخاب منابع مطمئن نیستید؟
اگر قصد دارید این پروژه را از حالت آزمایشی روی فلش به یک سرویس دائمی روی VPS منتقل کنید و در انتخاب RAM، CPU یا تنظیمات اولیه مشکل دارید، میتوانید درخواست کانفیگ و بررسی فنی خود را برای ایرانیکاسرور ارسال کنید.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور
هوش مصنوعی روی فلش بهتر است یا روی VPS؟
| ویژگی | فلش / SSD اکسترنال | VPS |
|---|---|---|
| اجرای کاملاً شخصی | بسیار مناسب | مناسب |
| قابلیت حمل فیزیکی | بله | نیازی ندارد |
| دسترسی ۲۴ ساعته | وابسته به کامپیوتر | بله، تا زمانی که سرور فعال است |
| استفاده بهعنوان API | برای توسعه محلی | برای سرویس دائمی مناسبتر |
| نیاز به اینترنت | برای اجرای محلی پایه خیر | برای دسترسی از راه دور بله |
پس این دو روش رقیب مطلق یکدیگر نیستند. فلش برای Portable AI جذاب است؛ VPS زمانی معنا پیدا میکند که بخواهید AI به یک سرویس دائمی، API یا دستیار قابل دسترسی از چند دستگاه تبدیل شود.
سؤالات متداول درباره ساخت هوش مصنوعی آفلاین روی فلش
آیا واقعاً میتوان هوش مصنوعی را داخل فلش قرار داد؟
بله. فایل مدل GGUF و برنامه اجراکننده میتوانند روی فلش قرار بگیرند؛ اما CPU، RAM و GPU مورد نیاز برای پردازش متعلق به کامپیوتر میزبان هستند.
آیا AI روی فلش بدون اینترنت کار میکند؟
پس از دانلود فایلهای مورد نیاز، اجرای محلی مدل در سناریوی این آموزش به اتصال اینترنت نیاز ندارد.
آیا کارت گرافیک برای llama.cpp اجباری است؟
خیر. مدلهای متناسب با منابع سیستم را میتوان روی CPU اجرا کرد. GPU سازگار میتواند در برخی پیکربندیها سرعت را افزایش دهد.
GGUF چیست؟
GGUF فرمتی است که در اکوسیستم llama.cpp برای نگهداری اطلاعات و وزنهای مدل استفاده میشود و نسخههای Quantized بسیاری از مدلها با این فرمت منتشر میشوند.
برای شروع چه مدل AI مناسبی است؟
برای یادگیری بهتر است با یک مدل کوچک Quantized شروع کنید. در این آموزش Gemma 3 1B نمونه مناسبی برای درک روش کار است.
آیا میتوان چند مدل را روی یک فلش ذخیره کرد؟
بله. محدودیت اصلی فضای ذخیرهسازی و منابع کامپیوتر میزبان است. میتوانید برای هر مدل یک BAT جداگانه بسازید.
آیا میتوان همین AI را روی سرور مجازی اجرا کرد؟
بله، در صورتی که VPS از نظر CPU و RAM و در صورت نیاز GPU با مدل انتخابشده سازگار باشد. برای مدلهای بزرگ باید منابع مورد نیاز را قبل از تهیه سرور دقیق بررسی کنید.
جمعبندی؛ یک AI کوچک که همیشه همراه شماست
برای تجربه Local AI لازم نیست کار را با یک سرور قدرتمند یا مدل چنددهمیلیارد پارامتری شروع کنید. ترکیب llama.cpp + یک مدل GGUF سبک + فلش یا SSD اکسترنال یکی از سادهترین راهها برای آشنایی عملی با اجرای مدلهای زبانی روی سختافزار شخصی است.
ابتدا با مدلی کوچک مانند Gemma 3 1B شروع کنید، فایل BAT بسازید و اجرای آفلاین را آزمایش کنید. بعد از آن میتوانید مدلهای بزرگتر، GPU acceleration، رابط وب و در مرحله حرفهایتر اجرای دائمی مدل روی VPS را تجربه کنید.
ایرانیکاسرور؛ ارائهدهنده سرور مجازی ایران، سرور مجازی خارج و سرویسهای میزبانی برای پروژههای مختلف.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور

دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.