
ساخت AI Log Analyzer روی VPS؛ تحلیل هوشمند لاگهای Linux، Docker و NGINX با Ollama و گزارش خودکار خطا
در این مقاله چه چیزی میسازیم؟ 🔹 جمعآوری خودکار لاگهای Linux، NGINX و Docker 🔹 اجرای مدل زبانی محلی با Ollama روی…
مجموعه آموزشها و راهنماهای مرتبط با این موضوع را در این صفحه دنبال کنید.
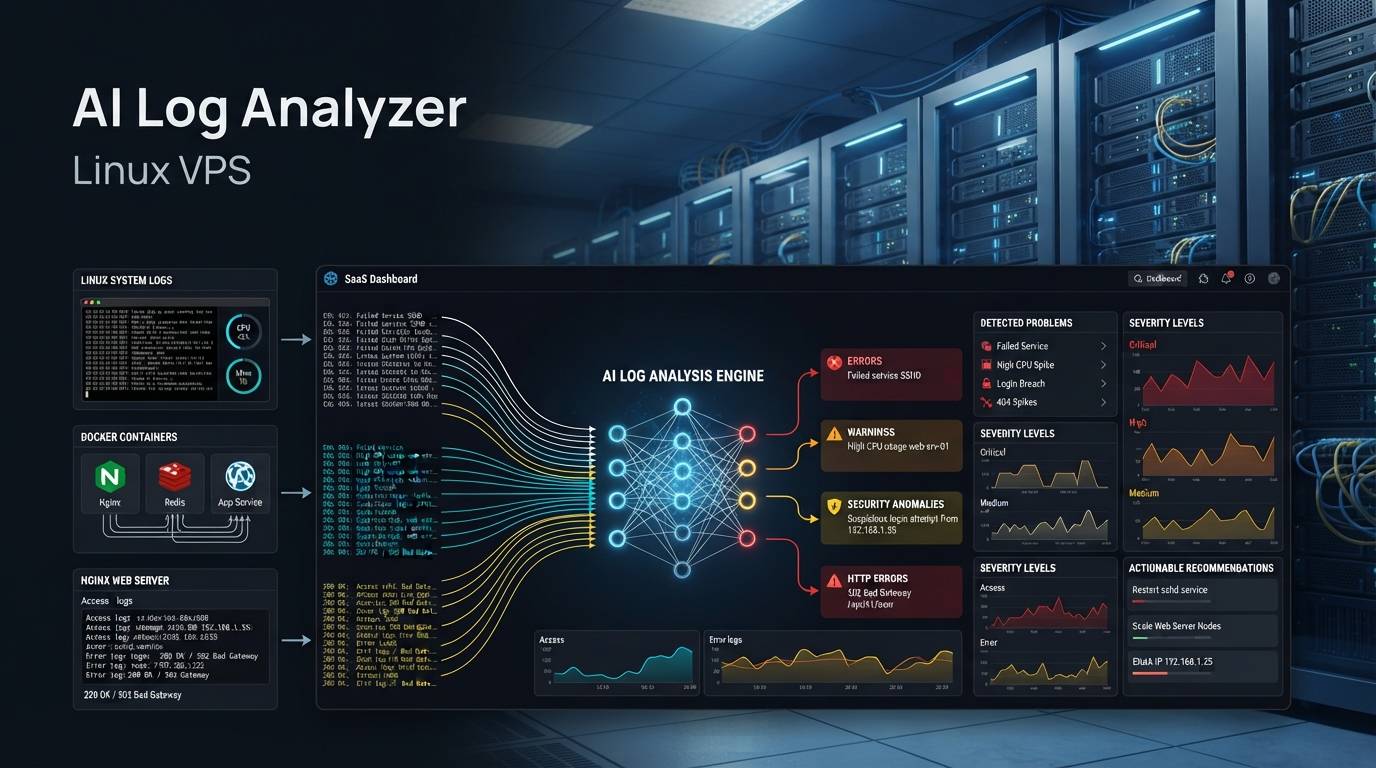
در این مقاله چه چیزی میسازیم؟ 🔹 جمعآوری خودکار لاگهای Linux، NGINX و Docker 🔹 اجرای مدل زبانی محلی با Ollama روی…
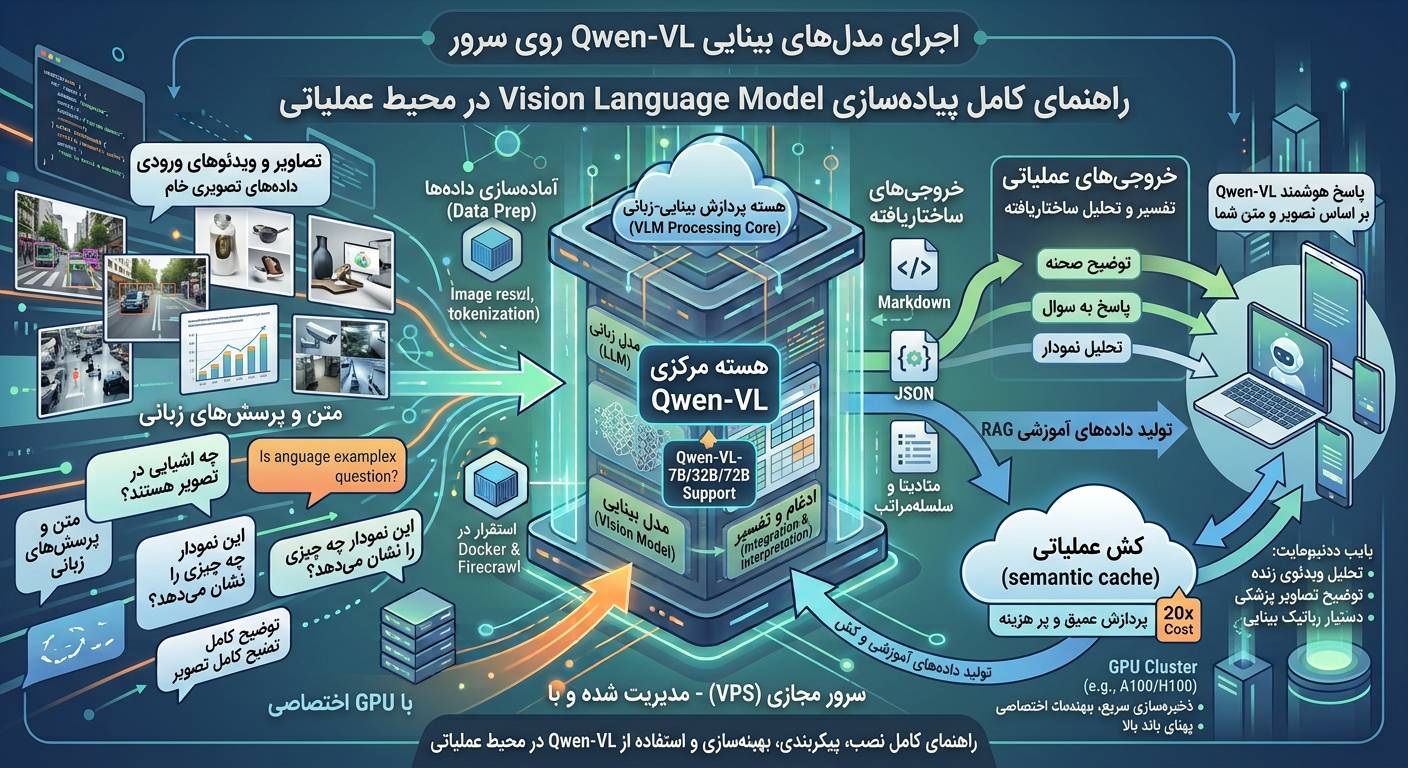
تا چند سال پیش، تصور اینکه یک ماشین بتواند تصویر ببیند، متن داخل آن را بخواند و دربارهاش استدلال کند، شبیه داستانهای…
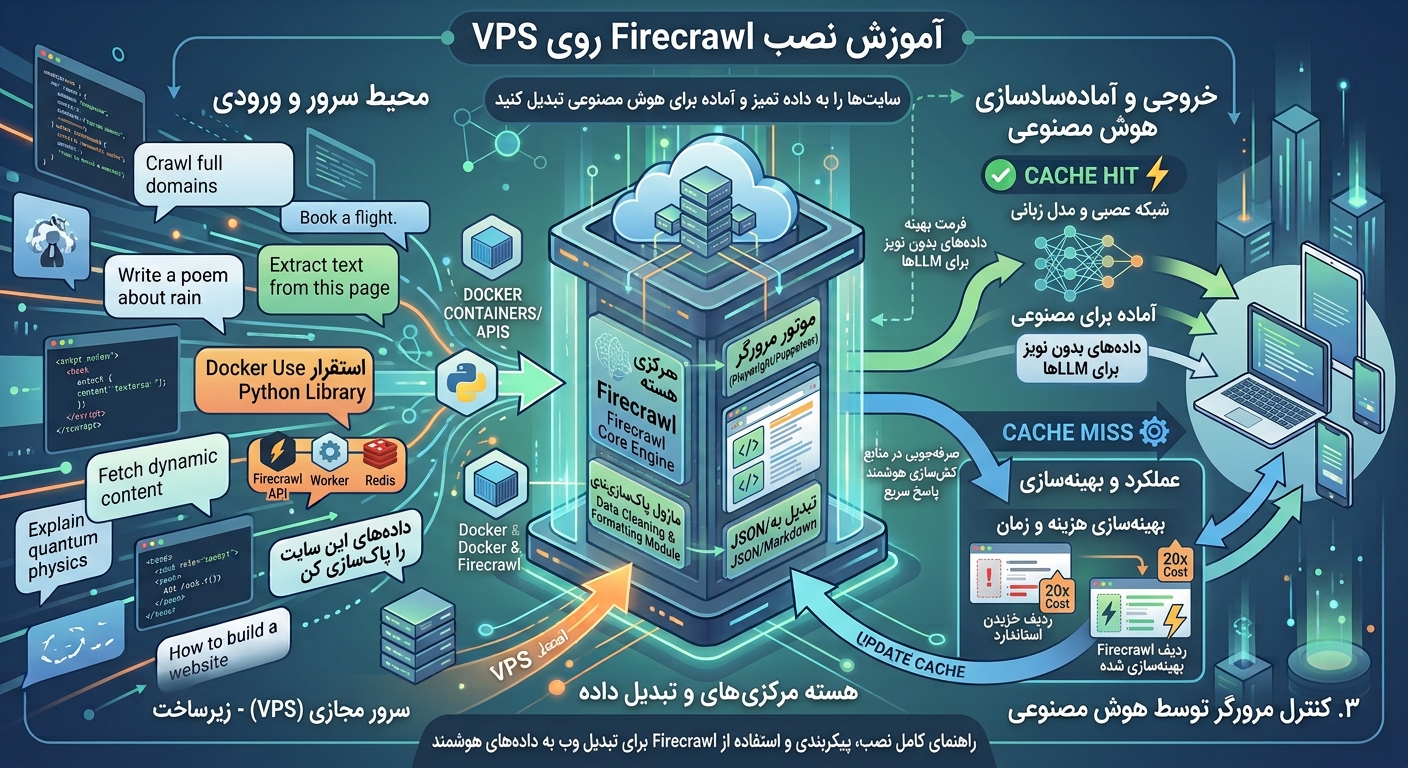
اگر روی پروژههای هوش مصنوعی کار میکنید، احتمالاً با این چالش روبهرو شدهاید: دادههای مورد نیازتان داخل صدها صفحه وب پخش شدهاند…
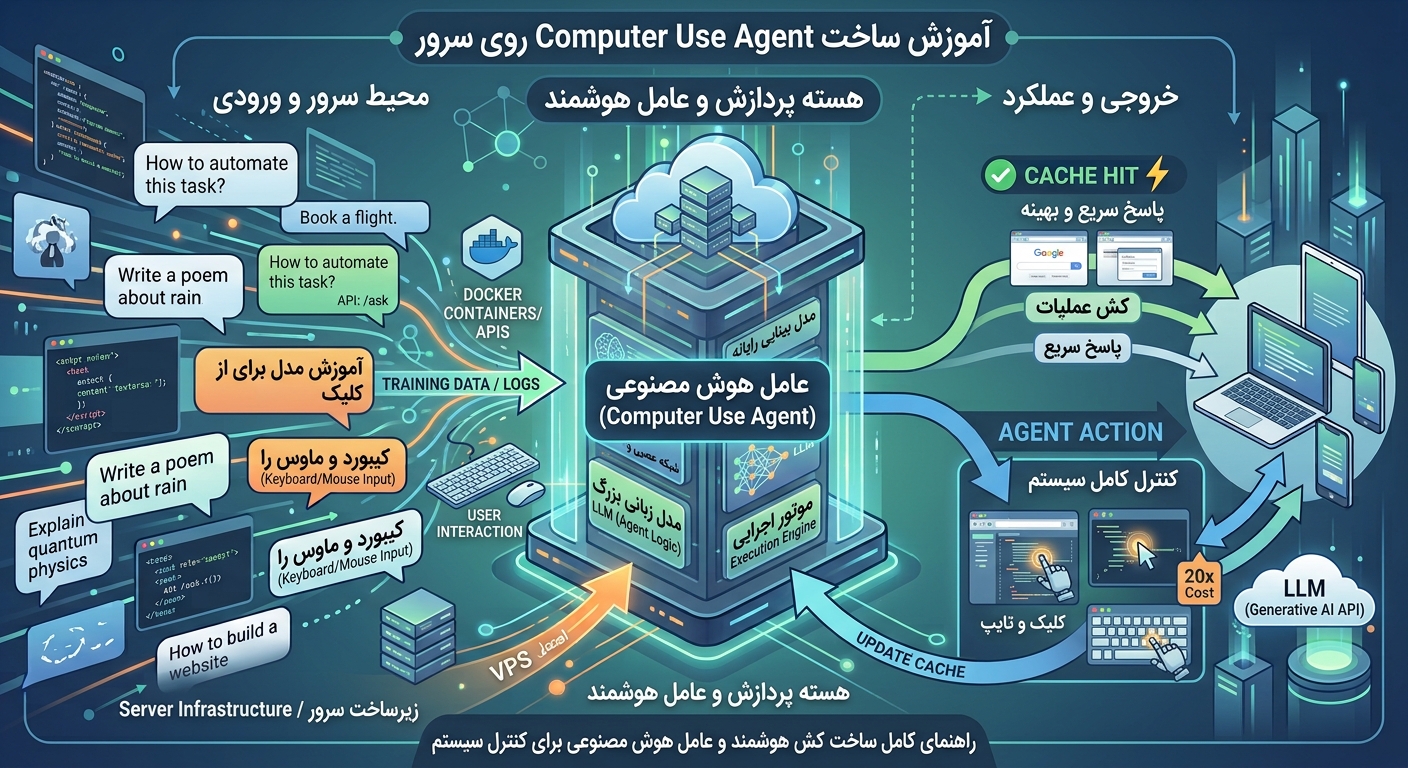
تصور کنید هوش مصنوعی نه فقط در مرورگر، بلکه روی کل دسکتاپ شما کار کند. موس را حرکت دهد، کلیک کند، تایپ…
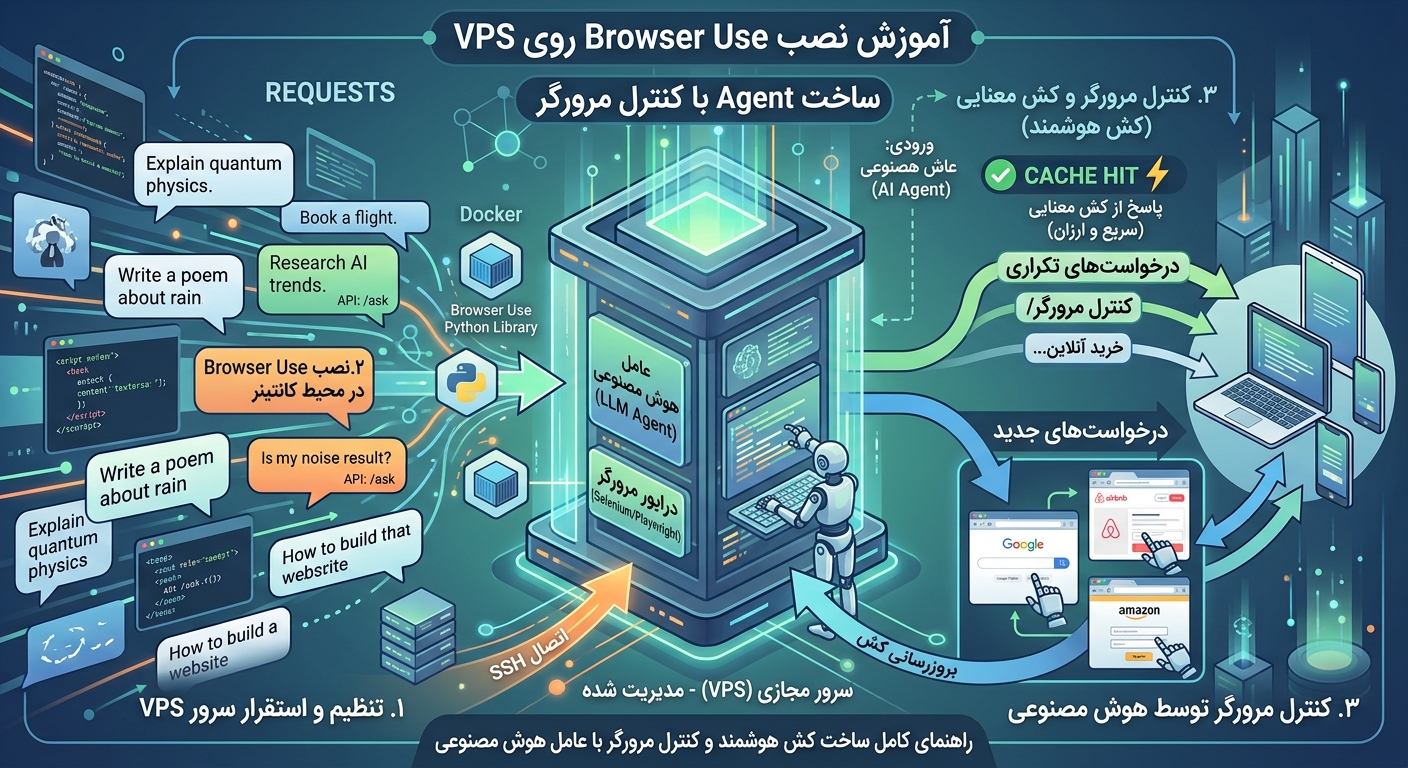
تصور کنید یک دستیار هوشمند دارید که بهجای شما وارد مرورگر میشود، فرمها را پر میکند، اطلاعات را از سایتهای مختلف استخراج…
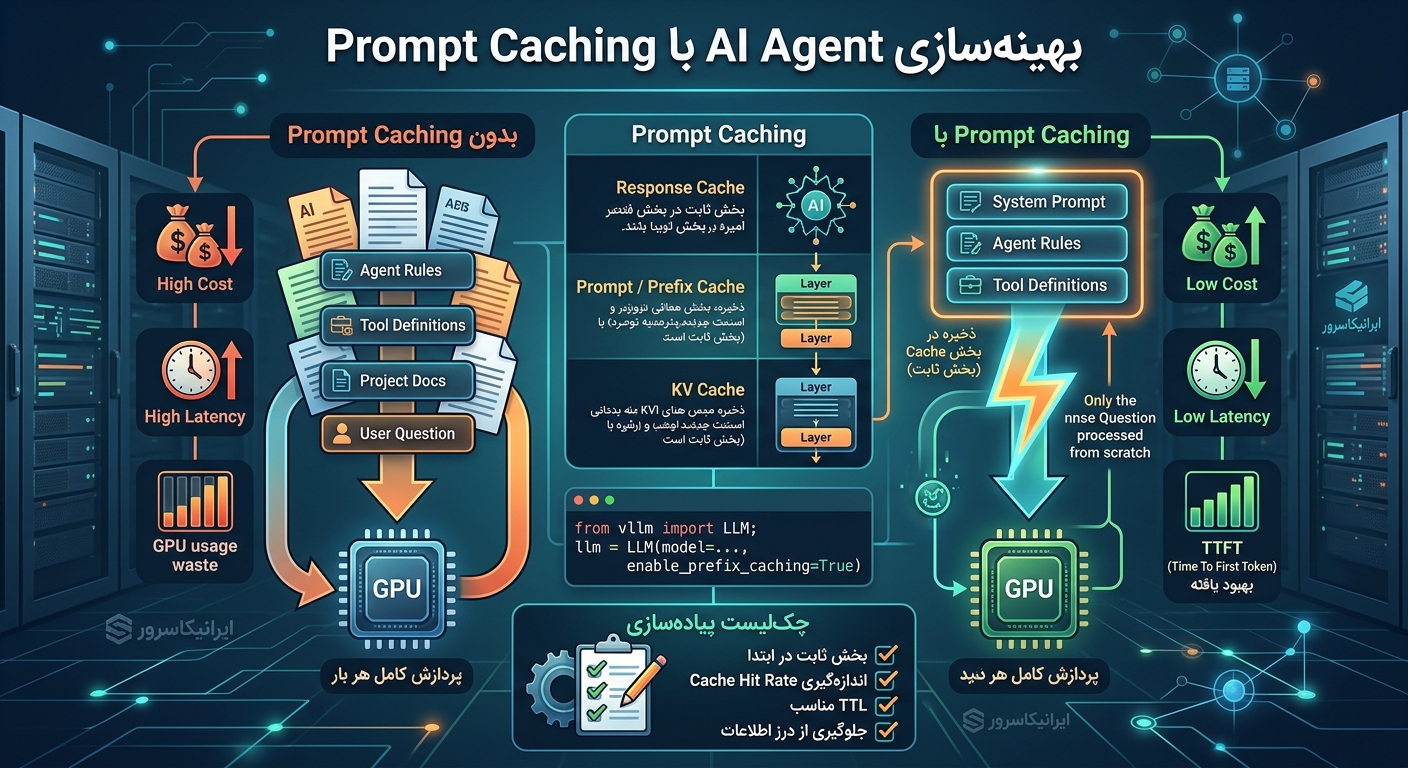
تصور کنید یک AI Agent سازمانی دارید که روزانه هزاران درخواست دریافت میکند. هر درخواست شامل یک System Prompt بزرگ، تعریف ابزارها،…
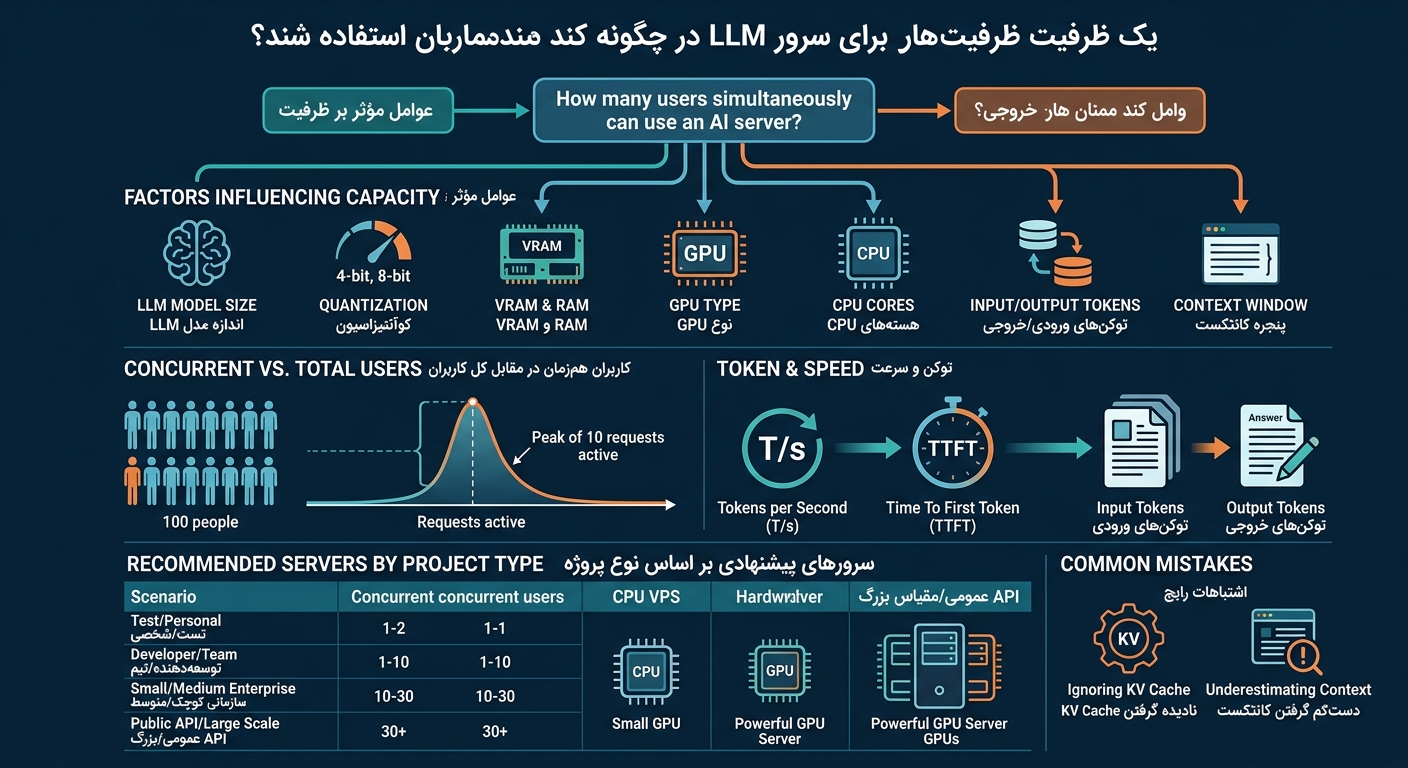
وقتی میخواهید یک سرور ماینکرفت برای دوستان یا یک جامعه کوچک راهاندازی کنید، اولین سؤال این است: چقدر رم و هسته CPU…
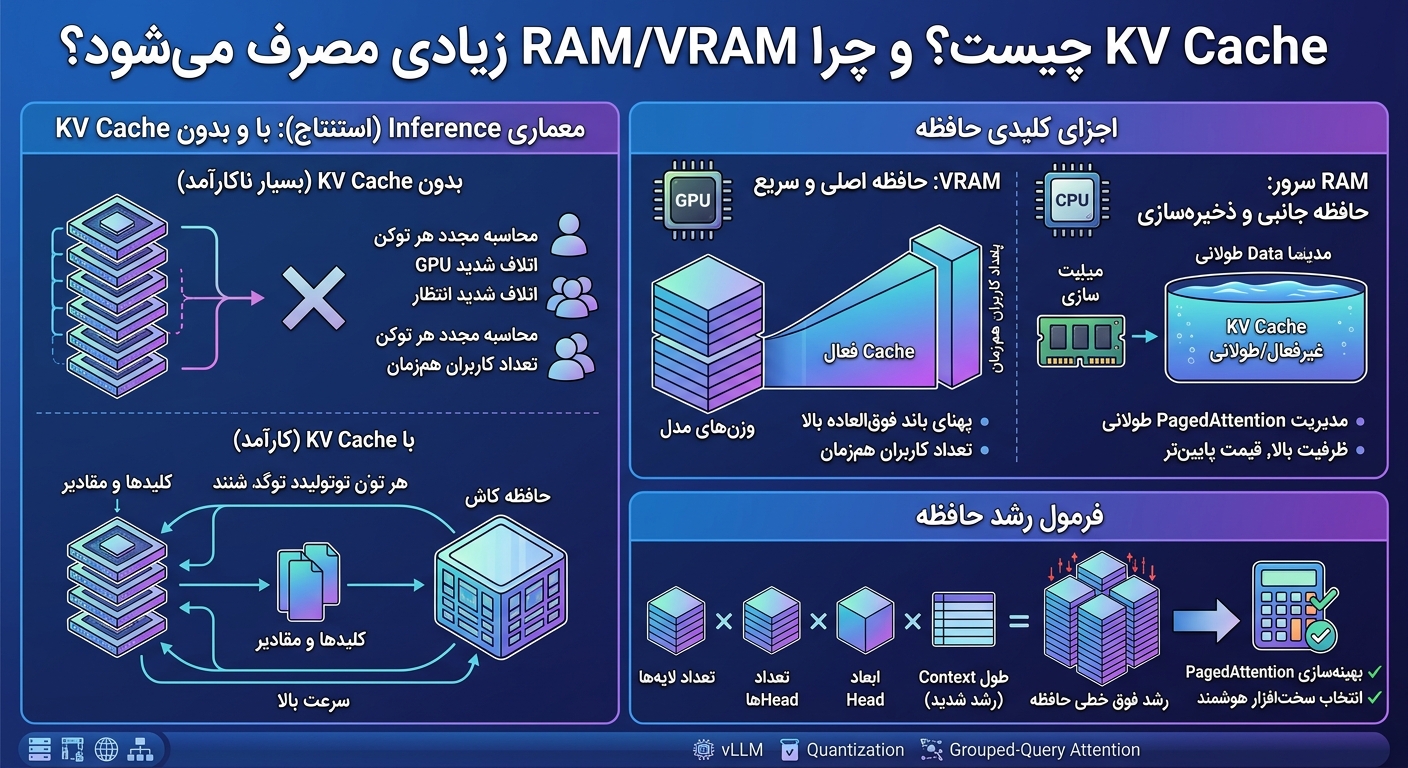
تصور کنید یک سرور مجازی قدرتمند با یک کارت گرافیک حرفهای اجاره کردهاید. همهچیز طبق محاسبات شما پیش میرود: حجم فایل مدل…
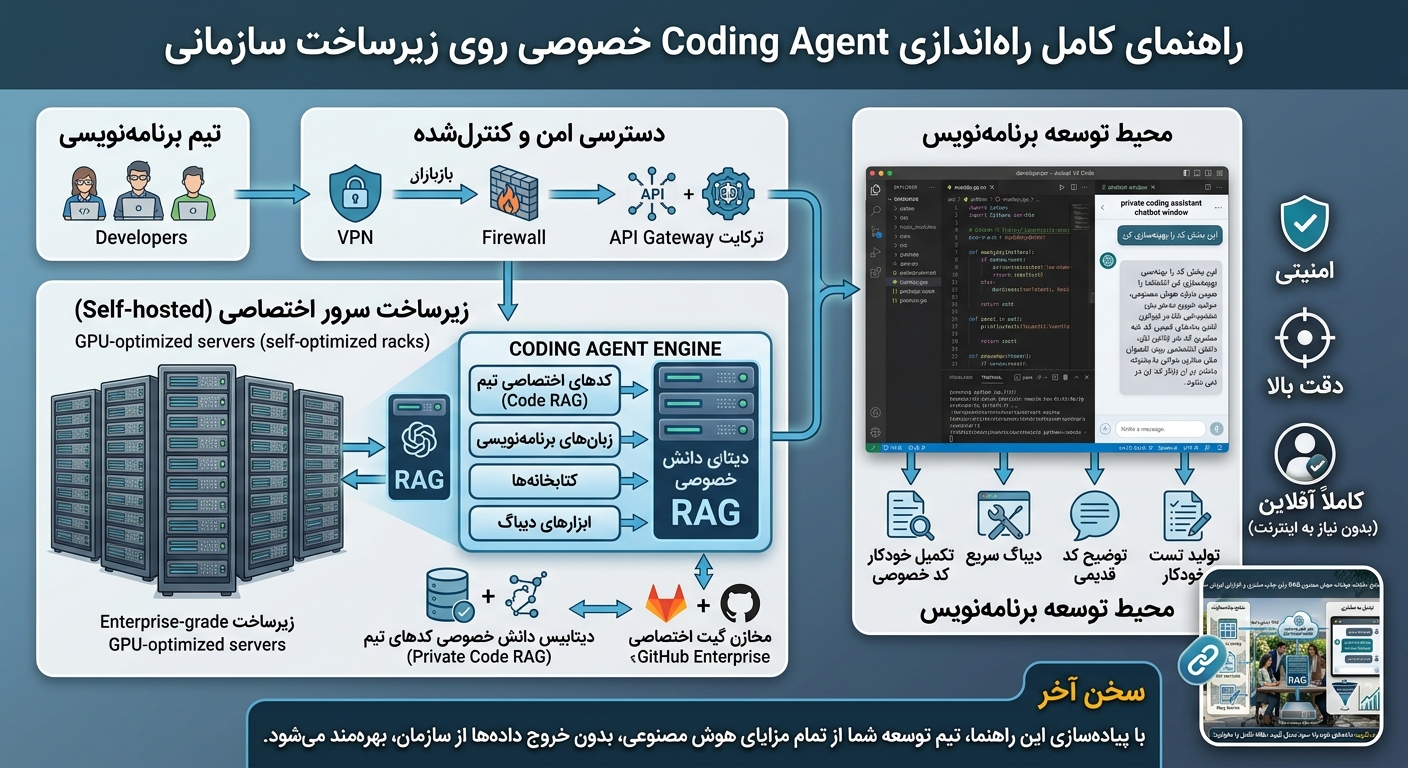
راهاندازی سرور هوش مصنوعی دقیقاً یعنی چه؟ وقتی درباره راهاندازی سرور هوش مصنوعی صحبت میکنیم، منظور فقط نصب یک مدل زبانی نیست.…
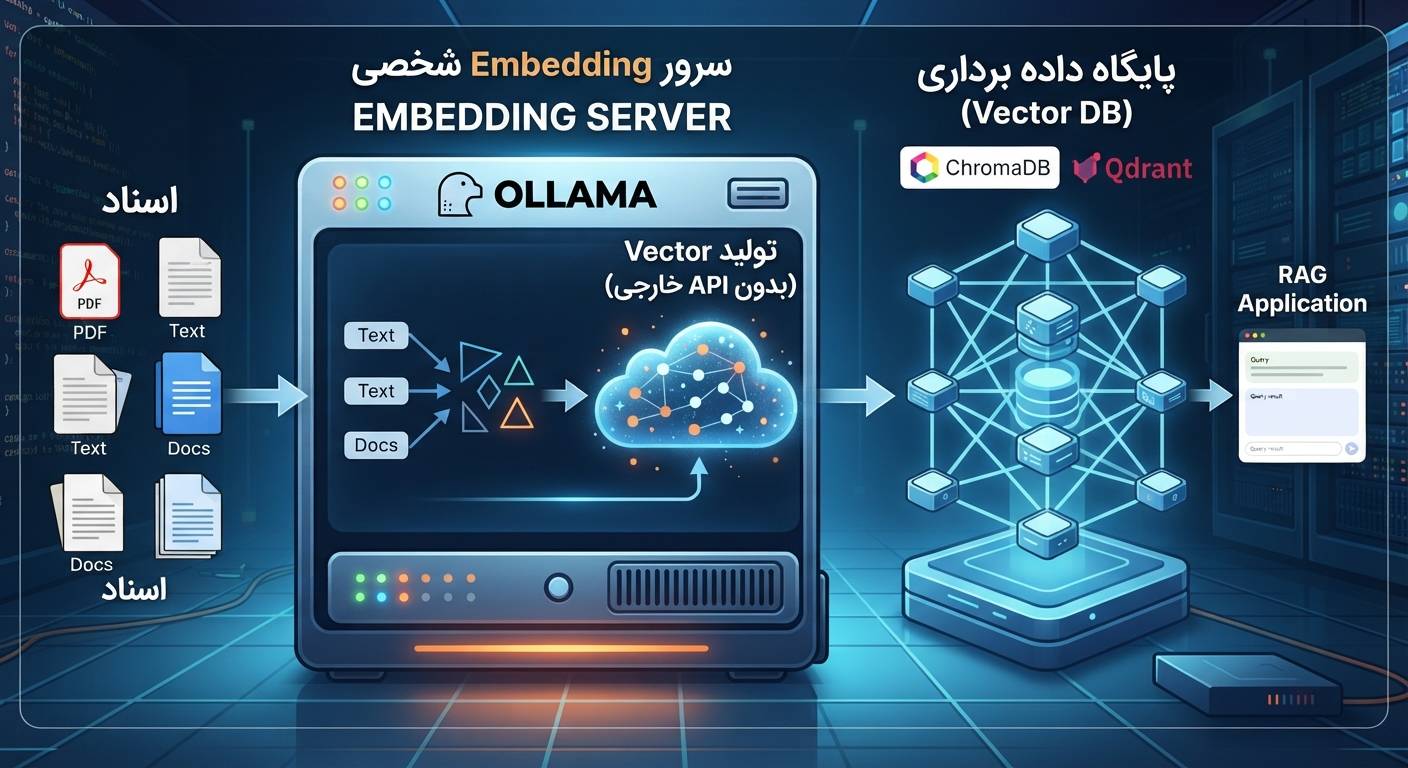
اگر روی پروژههای هوش مصنوعی، دستیار سازمانی یا چتبات مبتنی بر اسناد داخلی کار میکنید، حتماً با چالش Embedding مواجه شدهاید. سرویسهایی…
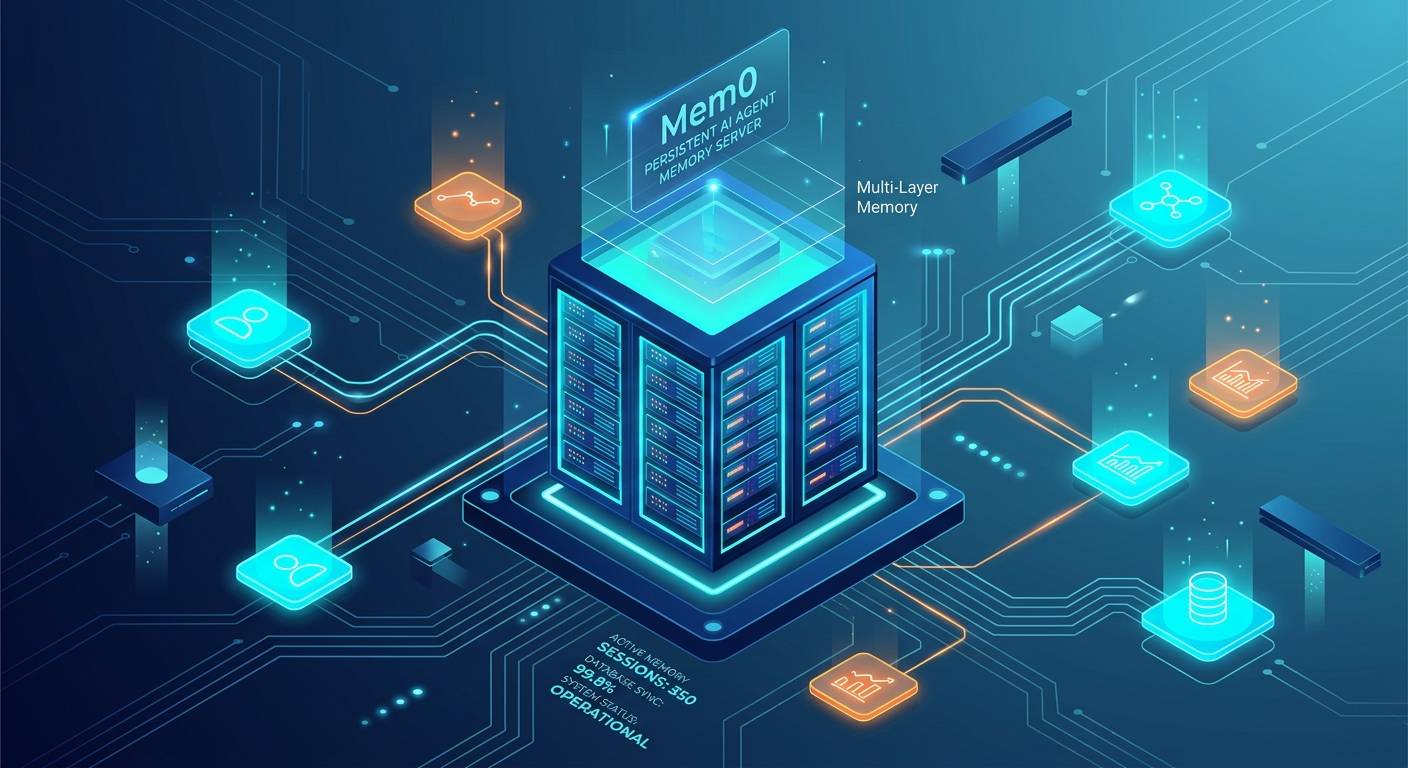
یکی از بزرگترین محدودیتهای مدلهای هوش مصنوعی مانند ChatGPT، Claude یا مدلهای متنباز این است که بعد از پایان هر گفتگو، اطلاعات…
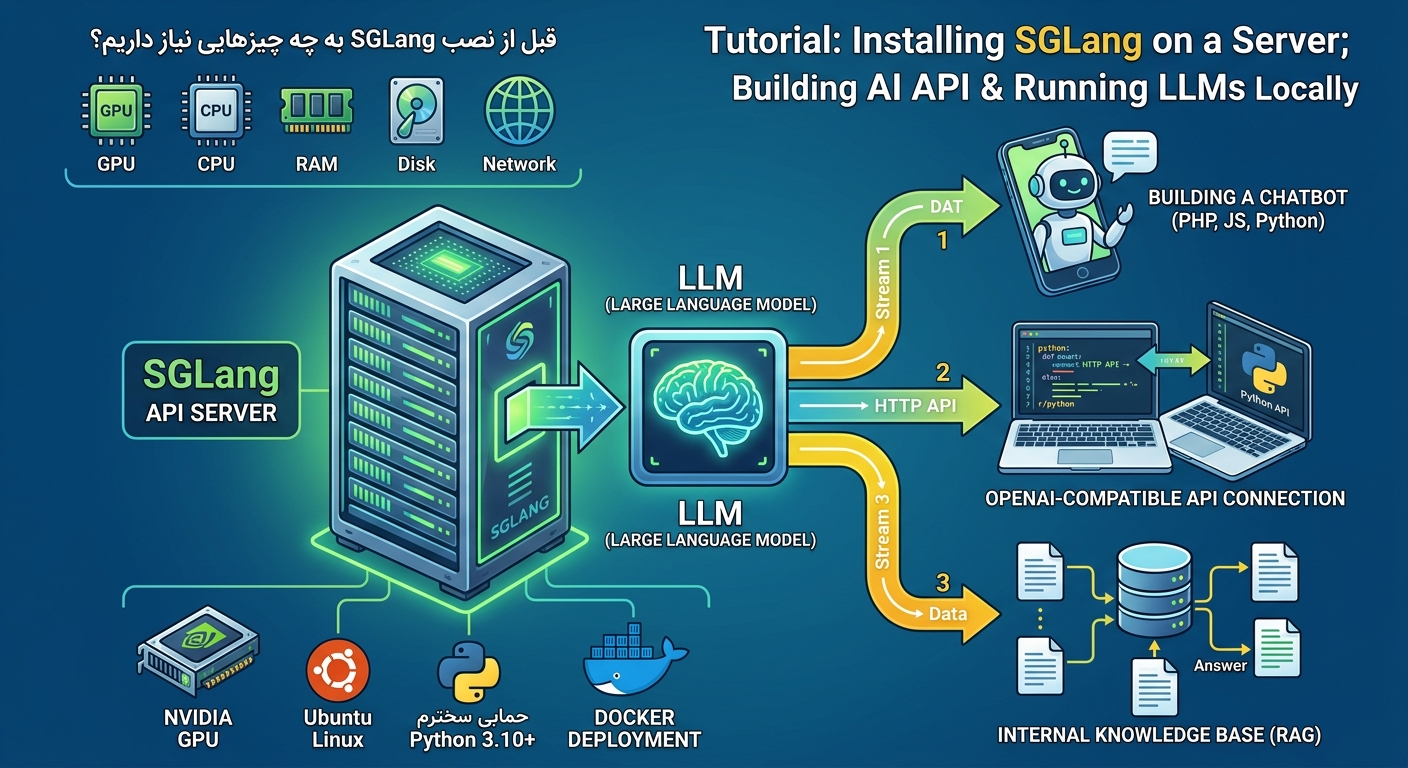
اگر بهدنبال راهی برای اجرای مدلهای زبانی بزرگ (LLM) روی زیرساخت شخصی خودتان هستید و میخواهید یک API مشابه سرویسهای هوش مصنوعی…